같은 주소를 열 번 고치지 않으려면: 데이터베이스 정규화
정규화는 관계의 함수 종속을 분석해 중복된 사실과 갱신 이상을 줄이도록 스키마를 나누는 과정이다. 단순히 표를 작게 쪼개거나 모든 중복 값을 없애는 작업은 아니다. 어떤 속성이 다른 속성을 결정하는지, 분해한 뒤 원래 사실을 정확하게 복원할 수 있는지를 기준으로 설계한다.
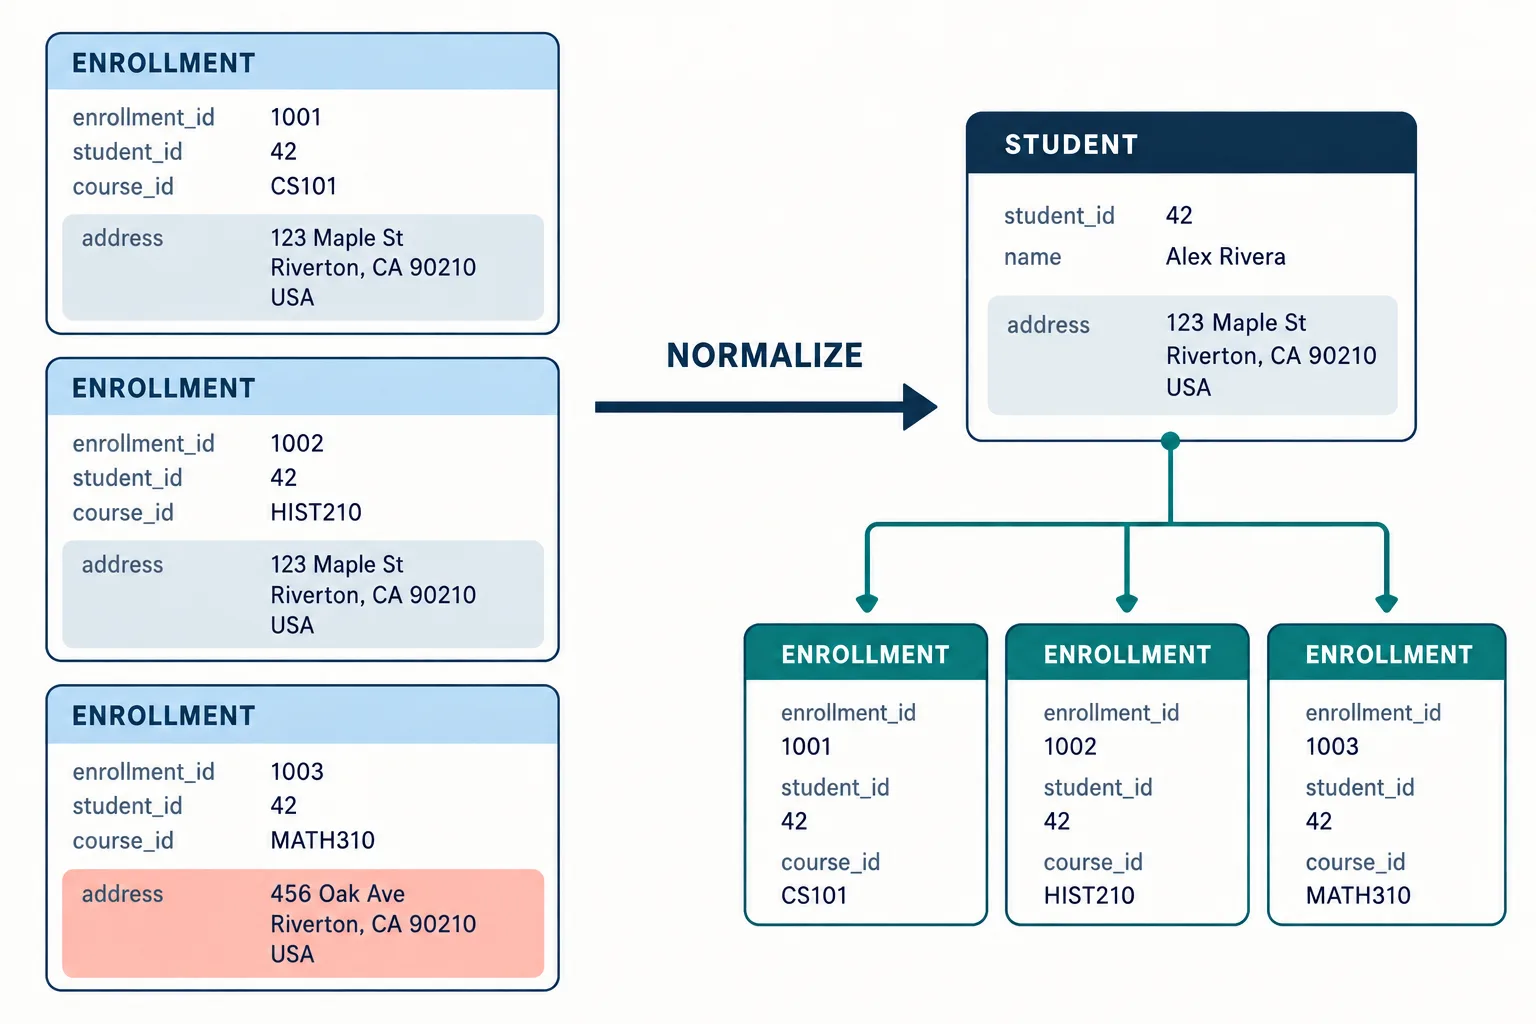
정규화는 다른 사실의 반복 저장을 줄여 갱신 책임을 분명히 한다.
데이터가 반복될 때 생기는 이상
수강 기록마다 학번, 학생 이름, 주소, 과목과 성적을 함께 저장한다고 하자. 한 학생이 열 과목을 들으면 주소가 열 번 반복된다. 이사 뒤 일부 행만 수정하면 같은 학생의 주소가 서로 달라진다. 수강을 모두 삭제하면 학생 정보까지 사라질 수 있고, 아직 수강하지 않은 학생을 넣기 어려울 수도 있다. 각각 수정, 삭제, 삽입 이상으로 설명할 수 있다.
함수 종속 X→Y는 같은 X 값을 갖는 두 튜플이 반드시 같은 Y 값을 갖는다는 의미다. 학번이 학생 주소를 결정한다는 규칙은 현재 데이터에서 우연히 값이 같아 보이는 현상보다 강한 스키마의 의미다. 샘플 표를 보고 항상 성립할 업무 규칙을 함부로 추정하면 잘못된 정규화를 할 수 있다.
키의 일부와 다른 사실을 분리한다
학생·과목 조합이 수강 행의 키일 때 학생 주소가 학번만으로 결정되면, 복합 키의 일부에 비키 속성이 의존한다. 2NF는 이런 부분 종속 문제를 다룬다. 학생 정보를 학생 관계로 분리하고 수강 관계에는 학번과 과목, 성적을 남기면 주소 변경을 한 곳에서 처리할 수 있다.
3NF와 BCNF는 다른 종속을 더 정밀하게 다룬다. BCNF는 비자명한 함수 종속 X→Y의 결정자 X가 슈퍼키여야 한다. 3NF는 이 조건이나 Y 쪽 속성이 후보키에 포함되는 속성이라는 조건 등을 사용해 일부 경우를 허용한다. 모든 비키 속성은 키에만 의존한다는 구호만으로 복잡한 후보키 상황을 정확히 판단하기는 어렵다.
분해에는 무손실성이라는 조건이 중요하다. 나눈 관계를 조인했을 때 원래 없던 가짜 튜플이 생기거나 원래의 튜플을 잃으면 좋은 분해라고 할 수 없다. 또한 종속 보존은 원래의 제약을 여러 관계의 조인 없이 각 분해 관계에서 검사할 수 있는지를 말한다. 더 강한 정규형으로 분해할 때 두 조건이 항상 원하는 형태로 동시에 달성되는 것은 아니다.
정규화는 조회 성능을 무조건 높이는 기법도 아니다. 중복 사실을 줄여 일관성 관리에 도움이 되지만 여러 관계를 조인하는 비용이 늘 수 있다. 읽기 중심 시스템에서는 측정 근거와 갱신 정책을 갖춘 비정규화를 선택하기도 한다. 이때 중복된 정보의 원본과 동기화 책임을 명시해야 한다.
한 학생의 여러 수강 행에 학번이 반복되는 것은 제거해야 할 잘못된 중복이 아니다. 수강이라는 사실이 학생을 참조하는 데 필요한 값이기 때문이다. 문제는 학번이 이미 결정하는 주소 같은 독립된 사실을 수강마다 함께 저장하는 데 있다. 값의 반복과 사실의 중복을 구분하면 정규화의 목적이 분명해진다.
설계를 검토할 때는 후보키와 함수 종속을 먼저 적고, 어떤 삽입·수정·삭제가 불편하거나 위험한지 구체적인 작업으로 확인한다. 이어 분해가 무손실인지, 제약이 어디서 검사되는지, 실제 주요 질의의 비용이 어떤지 살핀다. 정규형의 이름을 올리는 것보다 데이터의 의미와 변경 책임을 명확하게 만드는 것이 정규화의 실제 가치다.