같은 SQL이 다른 속도로 실행되는 이유: 쿼리 최적화
쿼리 최적화는 질의의 의미를 유지하면서 실행 비용이 더 낮을 것으로 예상되는 계획을 고르는 과정이다. SQL은 보통 원하는 결과를 선언하고, DBMS는 어떤 순서로 테이블을 읽고 어떤 조인 알고리즘을 사용할지 결정한다. 최적화라는 이름이 모든 상황에서 진짜 최선의 계획을 반드시 찾는다는 보장은 아니다.
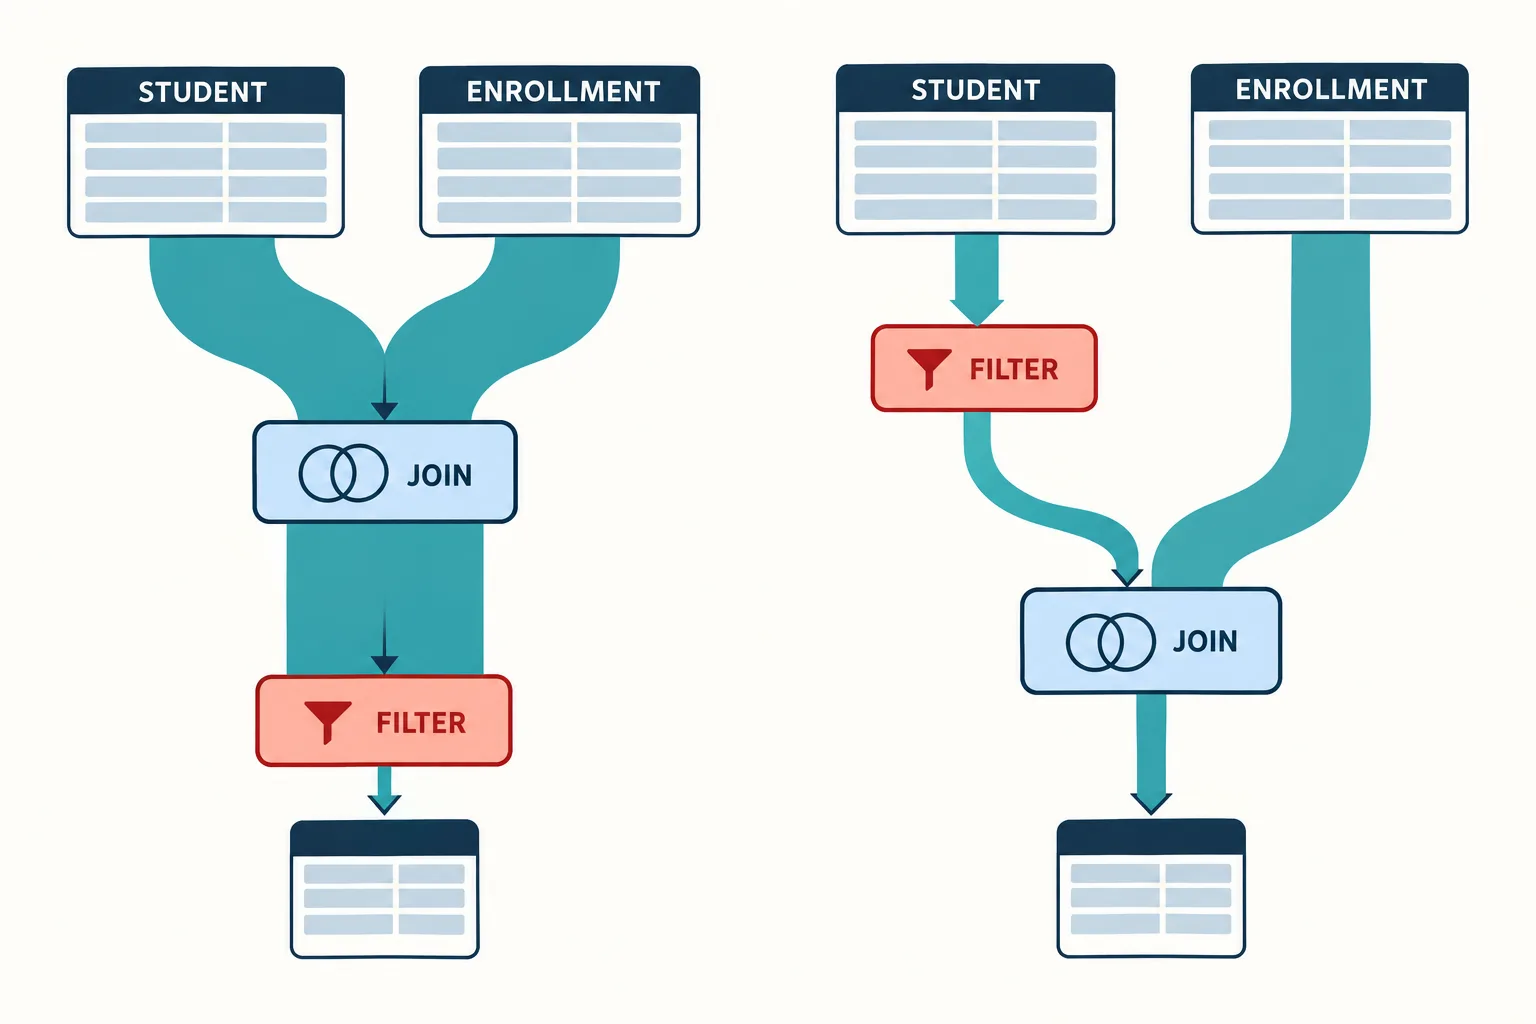
최적화기는 의미를 유지하는 여러 계획을 비교하되 비용과 행 수는 추정한다.
의미의 변환과 실행 방법의 선택
논리 계획은 선택, 투영, 조인 같은 관계 연산으로 질의를 나타낸다. 물리 계획은 순차 스캔인지 인덱스 스캔인지, 해시 조인인지 중첩 루프인지처럼 실제 실행 방법을 정한다. 같은 논리 연산이라도 입력 크기와 인덱스, 메모리 조건에 따라 적절한 물리 방법이 달라진다.
학생 테이블 백만 행과 수강 테이블 천만 행을 조인한 뒤 특정 학과 학생만 남긴다고 해 보자. 조건의 의미가 허용한다면 학생에 학과 필터를 먼저 적용해 작은 입력을 만들 수 있다. 그러면 조인에 참여하는 행과 중간 결과가 줄 가능성이 있다. 다만 필터의 선택도가 낮거나 사용할 접근 방법이 달라지면 예상 이익도 달라진다.
조인 순서는 여러 테이블에서 특히 중요하다. 작은 중간 결과를 먼저 만드는 순서와, 초반부터 거대한 조합을 만드는 순서는 같은 최종 결과라도 비용이 크게 다를 수 있다. 가능한 계획의 수가 빠르게 증가하므로 최적화기는 탐색 범위를 줄이거나 제한된 후보를 비교하는 전략을 사용한다.
비용은 실제 시간이 아니라 추정이다
최적화기는 행 수, 값 분포, 서로 다른 값의 수, 인덱스와 저장장치 비용 같은 정보를 이용한다. 예상 비용은 보통 추상적인 단위이며 실제 밀리초와 바로 같은 숫자가 아니다. 통계가 오래되거나 열들이 강하게 연관되어 있는데 독립적이라고 가정하면 예상 행 수가 크게 틀릴 수 있다.
예를 들어 도시와 우편번호는 서로 관련된 값이다. 두 조건의 선택도를 단순히 곱하면 현실보다 지나치게 적은 결과를 예상할 수 있다. 그런 오차는 작은 입력에 유리한 조인을 잘못 선택하게 만들고, 실제 실행에서 반복적인 읽기나 메모리 초과를 일으킬 수 있다. 데이터 분포를 반영하는 통계가 중요한 이유다.
EXPLAIN은 선택한 계획과 추정을 보는 데 도움이 된다. 실제 실행 정보를 함께 보는 기능은 추정 행 수와 실제 행 수를 비교하게 해 주지만 쿼리를 실행하므로, 쓰기 질의에서는 그 효과를 이해하고 사용해야 한다. 표면적으로 인덱스를 썼는지보다 어느 노드에서 예상과 현실이 크게 달라지는지 살피는 편이 유용하다.
모든 식 변환이 안전한 것은 아니다. 외부 조인, NULL, 중복 의미, 부수 효과가 있는 함수는 단순한 연산 교환의 조건을 복잡하게 만든다. 또한 실행 중 메모리 부족으로 정렬이나 해시 자료가 디스크로 넘어가면 기존 추정과 다른 비용이 생긴다. 논리적 동등성 검증과 물리 비용 예측은 각각 필요하다.
느린 쿼리를 개선할 때는 대표적인 실제 데이터와 부하를 기준으로 판단한다. 작은 개발용 표에서 빠른 계획이 운영 데이터에서도 빠르다고 가정할 수 없다. 통계 갱신, 적절한 인덱스, 질의 표현의 개선을 검토하고 추정과 실제 실행을 연결하면, 같은 SQL이 왜 다른 환경에서 다른 속도를 보이는지 구체적으로 설명할 수 있다.