계수 정렬: 비교 대신 키의 개수를 이용해 위치를 정하기
계수 정렬은 키가 제한된 정수 범위에 있을 때 각 값의 등장 횟수를 세어 정렬하는 알고리즘이다. 원소끼리 누가 큰지 비교하는 대신 값 자체를 배열 인덱스로 사용한다. 그래서 비교 정렬의 하한을 그대로 적용할 수 없다.
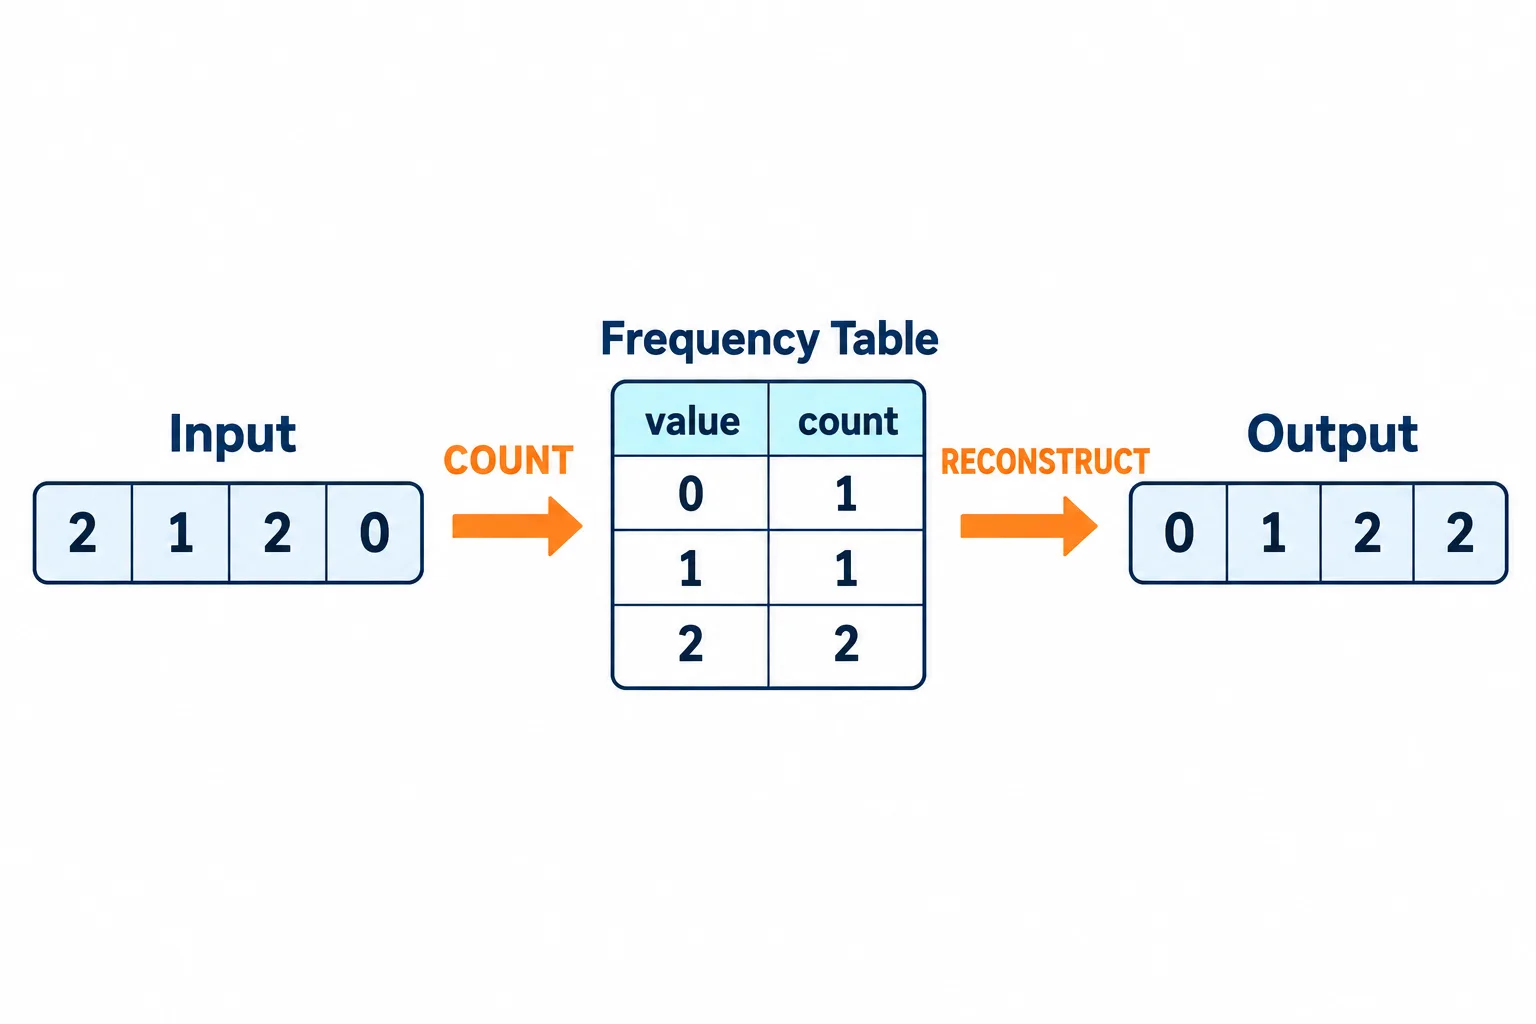
키의 범위가 관리 가능한 경우 빈도 정보를 정렬에 이용할 수 있다.
범위가 작아야 유리하다
n개 원소의 키가 0부터 k-1까지라고 하자. 길이 k 빈도 배열을 만들고 각 키의 수를 센다. 단순히 숫자만 정렬하면 빈도만큼 순서대로 출력하면 되지만, 키와 함께 학생 이름 같은 정보를 보존하려면 각 원소의 최종 위치를 구해야 한다.
빈도를 누적하면 키 x 이하인 원소 수가 나온다. 이 값에서 1을 뺀 위치가 키 x 원소가 들어갈 마지막 위치다. 입력을 뒤에서부터 읽고 그 위치를 하나씩 줄이면 동일 키의 원래 순서가 보존된다.
def counting_sort(records, key, key_range):
    cumulative = [0] * key_range
    for record in records:
        cumulative[key(record)] += 1
    for value in range(1, key_range):
        cumulative[value] += cumulative[value - 1]
    output = [None] * len(records)
    for record in reversed(records):
        value = key(record)
        cumulative[value] -= 1
        output[cumulative[value]] = record
    return output
코드는 모든 키가 정수이고 0≤key<key_range임을 가정한다. 이 검사를 생략한 채 음수 키를 넣으면 Python에서는 뒤쪽 인덱스로 접근해 더 위험한 오동작이 생길 수 있다.
누적합으로 위치를 읽기
키 [2,0,2,1]의 빈도는 [1,1,2], 누적 수는 [1,2,4]다. 뒤의 2는 위치 3, 1은 위치 1, 앞의 2는 위치 2, 0은 위치 0에 들어간다. 두 개의 2는 원래 앞뒤 순서를 유지한다. 역방향 배치와 감소 시점이 안정성의 근거다.
시간은 O(n+k), 보조 공간도 출력 배열을 포함하면 O(n+k)다. n이 작아도 k가 10억이면 큰 빈도 배열 초기화가 부담이다. 키 종류가 적다는 말과 최대·최소 사이 범위가 작다는 말도 다르다. 매우 큰 띄엄띄엄한 키에는 다른 방법이 낫다.
음수나 일정 구간의 키는 최솟값을 빼 인덱스로 옮길 수 있지만 범위 k는 여전히 확인해야 한다. 임의 문자열이나 실수 전체에는 이 전제를 바로 적용할 수 없다.
안정 계수 정렬은 자릿수별로 처리하는 기수 정렬의 부품으로도 사용된다. 계수 정렬이 빠른 이유는 특별한 키 구조를 활용하기 때문이며, 모든 데이터에서 O(n) 정렬을 가능하게 하는 만능 방식은 아니다.
희소한 키를 작은 순위로 바꾸는 좌표 압축은 도움이 될 수 있지만 그 순위를 만들기 위해 정렬이 필요할 수 있다. 전처리 비용을 숨기고 전체를 선형 시간이라고 하면 부정확하다.