공유 회선 위의 작은 조각들: 패킷 교환의 원리
패킷 교환은 데이터를 유한한 크기의 전송 단위로 나누고, 여러 통신이 같은 링크와 중간 장비를 공유하게 하는 방식이다. 각 패킷에는 전달에 필요한 제어 정보가 붙는다. 특정 사용자에게 통신 내내 고정 대역폭을 예약하는 회선 교환과 달리, 사용자가 실제로 보내는 순간에 자원을 이용한다.
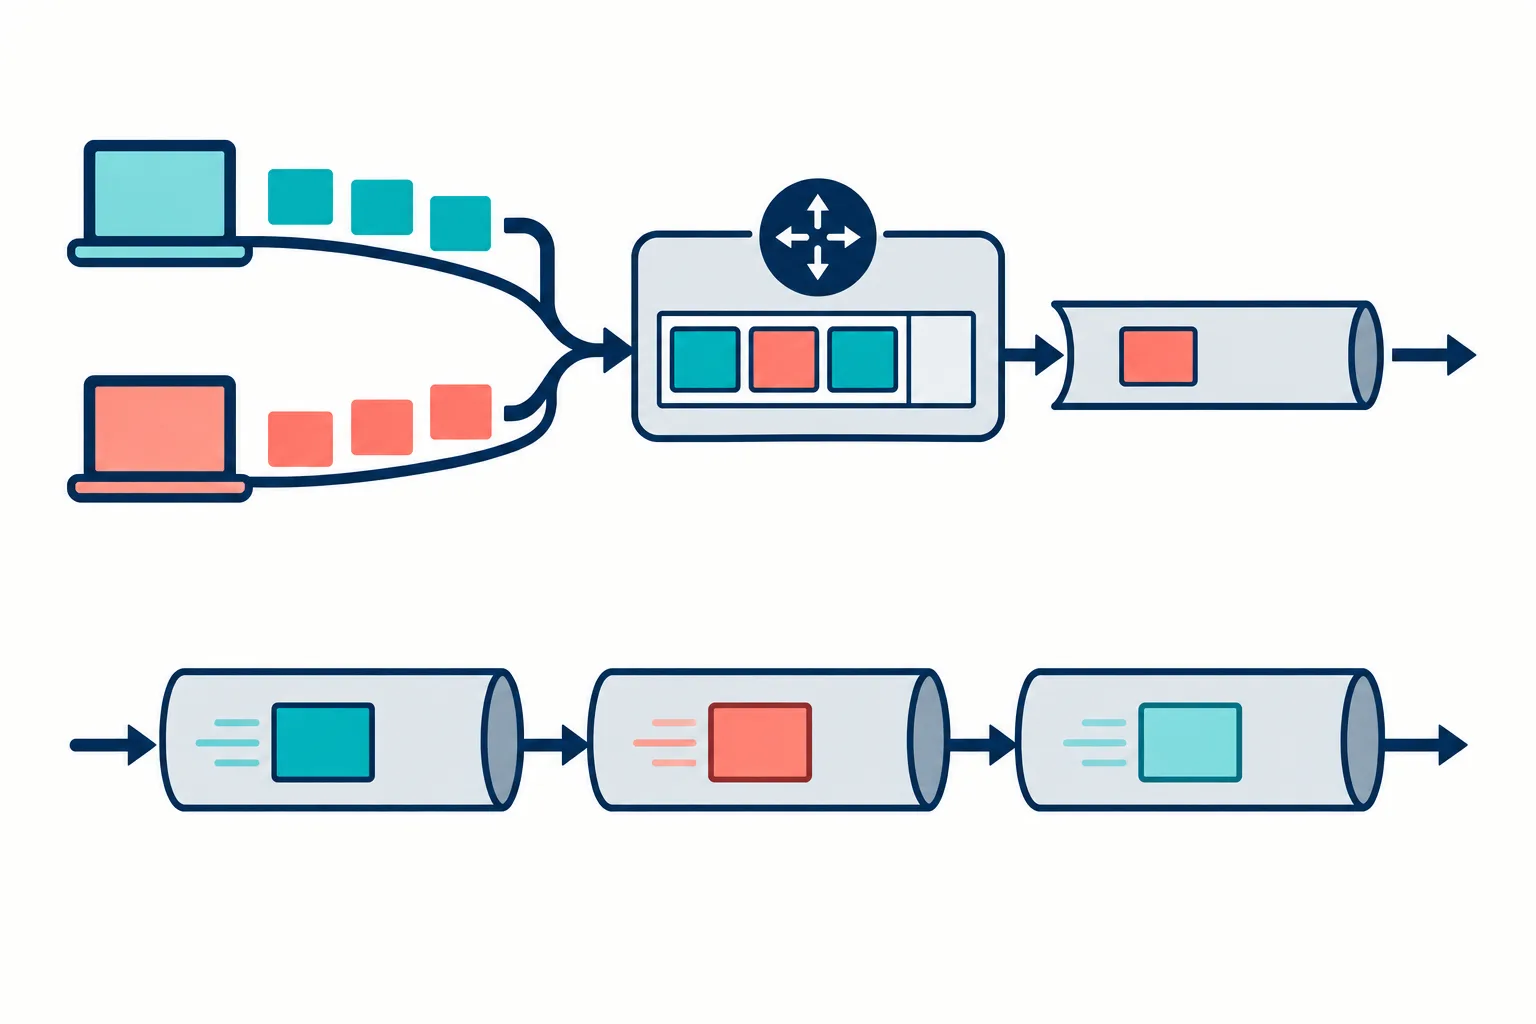
공유 링크는 사용률을 높이지만 순간 부하가 용량을 넘으면 대기와 손실을 만든다.
공유가 만드는 효율과 대기
두 사용자가 각각 가끔 큰 파일을 보낸다면 전용 회선을 반씩 나누는 방식은 쉬는 쪽의 용량을 활용하지 못할 수 있다. 패킷 교환에서는 한 사용자가 조용할 때 다른 사용자의 패킷이 링크를 더 많이 이용한다. 이런 통계적 다중화는 개별 사용자의 순간적인 요구가 동시에 최고치에 도달하지 않는 환경에서 특히 효과적이다.
반대로 둘이 한꺼번에 전송하면 패킷들이 출력 링크 앞의 큐에서 기다린다. 들어오는 속도가 나가는 속도를 지속적으로 넘으면 큐가 길어지고, 버퍼가 가득 차면 손실이 발생한다. 버퍼를 크게 한다고 처리 능력이 늘어나는 것은 아니다. 손실을 늦추는 대신 대기 시간을 크게 만드는 상황도 생긴다.
크기가 L비트인 패킷을 속도 R비트/초의 링크에 밀어 넣는 직렬화 시간은 L/R이다. 12,000비트 패킷을 1Mbps 링크로 보내면 이 시간만 12ms다. 이는 신호가 공간을 이동하는 전파 시간과 다르다. 링크 앞에서 기다리는 큐잉 시간과 장비의 처리 시간도 별도로 더해진다.
한 번에 한 홉씩
저장 후 전달 방식에서는 장비가 패킷을 받아 저장하고 검사한 뒤 다음 링크로 전달한다. 단순한 모델에서 같은 속도의 세 링크를 큐잉 없이 통과하는 첫 패킷의 직렬화 비용은 3L/R이다. 그러나 여러 패킷을 연속으로 보내면 앞 패킷이 두 번째 링크를 지나는 동안 뒤 패킷은 첫 링크를 이용할 수 있다. 이 파이프라이닝 때문에 전체 파일의 시간이 패킷 수 곱하기 첫 패킷 시간과 같지는 않다.
패킷이 항상 같은 경로를 따라가거나 순서대로 도착한다는 보장은 별도의 문제다. 경로 변경, 서로 다른 큐, 손실 복구가 도착 순서를 바꿀 수 있다. IP의 전달 서비스 위에서 TCP 같은 프로토콜이 순서와 재전송을 관리하거나, 응용이 자체적으로 필요한 보장을 구현한다.
패킷 크기에도 타협이 있다. 아주 작으면 헤더 비중과 처리 횟수가 커지고, 아주 크면 한 패킷이 링크를 오래 점유하며 최대 전송 크기 제약에 걸릴 수 있다. 따라서 좋은 성능을 평가하려면 평균 대역폭 외에 부하가 몰리는 방식, 큐 길이, 지연 분포, 손실률까지 관찰해야 한다.
작은 계산으로 병목을 구분할 수 있다. 패킷 하나의 직렬화 시간이 12ms라도 앞에 같은 크기의 패킷이 열 개 기다리면 순수 대기만 약 120ms가 추가된다. 링크의 물리적 거리를 줄여도 이 큐잉 비용이 자동으로 사라지지는 않는다. 반대로 링크 속도를 높이면 직렬화와 큐 배출은 빨라지지만 거리에서 생기는 전파 지연은 그대로다. 부하가 낮을 때의 측정과 동시에 많은 사용자가 전송할 때의 측정을 함께 비교해야 하는 이유다. 패킷 교환의 효율은 공유가 잘 작동하는 조건에서 얻는 것이며, 모든 사용자가 항상 최대 속도를 요구하는 경우 필요한 총용량을 없애는 마법은 아니다.