기수 정렬: 자릿수별 안정 정렬이 전체 순서를 만드는 원리
기수 정렬은 키를 여러 자리로 나누어 각 자리별 정렬을 반복한다. LSD 방식은 가장 낮은 자리부터 시작해 높은 자리로 올라간다. 비교 한 번으로 전체 값을 비교하기보다 표현의 구조를 활용한다.
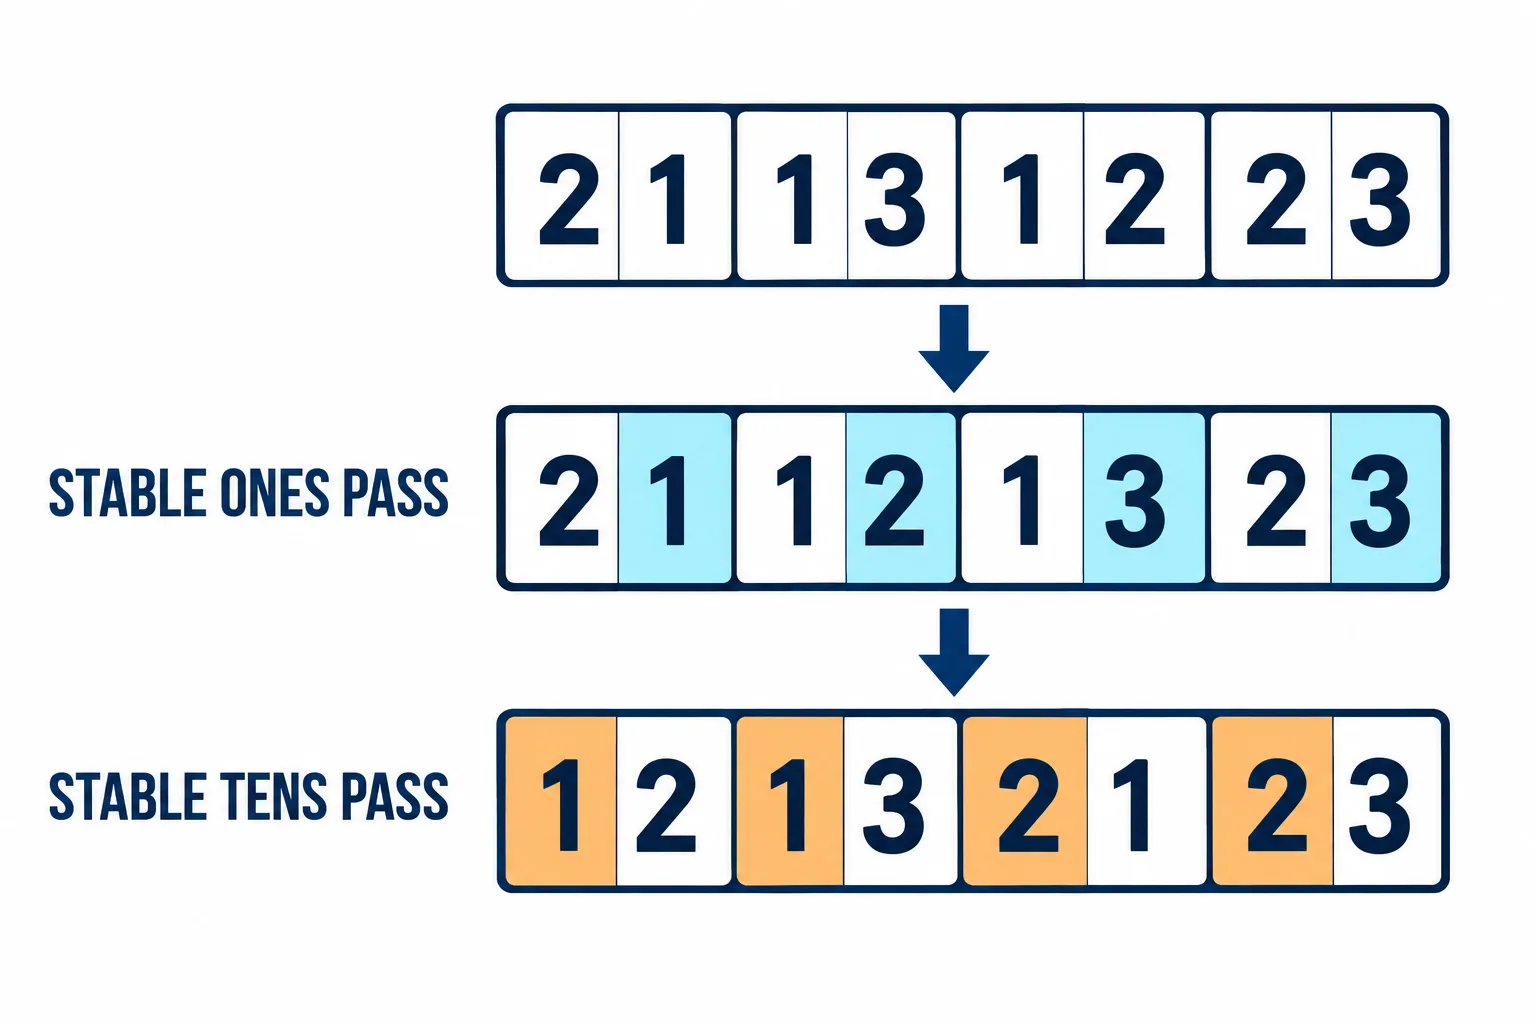
낮은 자리부터 정렬할 때 각 단계의 안정성이 앞 단계의 결과를 보존한다.
안정성이 필요한 이유
십진수 [170,45,75,90,802,24,2,66]을 일의 자리로 안정 정렬하면 같은 일의 자리 안에서는 기존 순서를 유지한다. 다음 십의 자리 정렬은 십의 자리 순서를 만들면서 그 안에 이미 정리된 일의 자리 순서를 남긴다. 이 규칙을 반복하면 높은 자리부터 낮은 자리까지의 전체 순서가 된다.
안정 정렬이 아니면 십의 자리가 같은 원소들의 일의 자리 순서가 다시 뒤집힐 수 있다. 각 자리에서 정렬했다는 사실만으로 충분하지 않다. 이전 자리의 결과를 보존해야 한다는 귀납적 불변식이 있다.
Input:          21a, 12, 11, 21b
After ones:     21a, 11, 21b, 12
After tens:     11, 12, 21a, 21b

At each pass:
    count the current digit of every key
    compute cumulative bucket boundaries
    place records stably into a temporary array
    use that array as input for the next digit
21a와 21b는 같은 키에 서로 다른 정보를 가진 레코드다. 일의 자리에서 1인 원소의 상대 순서를 지킨 뒤 십의 자리에서도 지켜 최종 동률 순서를 보존한다. 이 작은 예가 안정 정렬을 반복해야 하는 이유를 보여준다.
시간은 자리 수와 기수에 달려 있다
자리 수 d, 각 자리의 값 종류 b에 대해 안정 계수 정렬을 사용하면 O(d(n+b)) 시간이다. 보조 공간은 대개 O(n+b)다. “항상 O(n)”이라고 표현하기보다는 d와 b를 상수로 볼 수 있는 입력 모델인지 명시해야 한다.
32비트 비음수 정수를 8비트씩 처리하면 b=256, d=4인 구조를 생각할 수 있다. 한 번에 더 많은 비트를 처리하면 d는 줄지만 빈도 배열이 커진다. 메모리와 초기화 비용을 고려한 절충이 필요하다.
자리 수가 다른 비음수 정수는 앞에 0이 있는 것으로 취급할 수 있다. 음수는 부호와 순서를 보존하는 변환이나 별도 처리가 필요하다. 부동소수점의 비트 패턴을 그대로 unsigned 정수처럼 정렬하면 원하는 수치 순서가 자동으로 얻어지지 않는다.
MSD 방식은 높은 자리부터 나누며 문자열과 가변 길이 키에 활용할 수 있지만 종료 조건과 하위 그룹 처리 방식이 다르다. LSD 방식의 논리를 그대로 대입해서는 안 된다.
기수 정렬은 고정 폭 키를 대량 처리할 때 강점이 있다. 반면 임의 비교 함수나 복잡한 객체 순서를 그대로 지원하지는 않는다. 데이터 표현, 안정성, 자릿수 비용을 함께 확인해야 성능 주장과 실제 요구가 맞는다.
빈도 배열의 초기화도 각 패스의 비용에 포함한다. 기수를 크게 잡으면 패스 수는 줄어도 메모리와 초기화 비용이 커진다.