누적 합: 구간 전체를 다시 더하지 않는 전처리
누적 합은 배열 시작부터 각 위치까지의 합을 미리 저장하는 방법이다. 같은 배열에서 여러 구간 합을 묻는다면 구간마다 다시 순회할 필요가 없다. 한 번의 O(n) 전처리로 이후 질의를 O(1)에 처리한다.
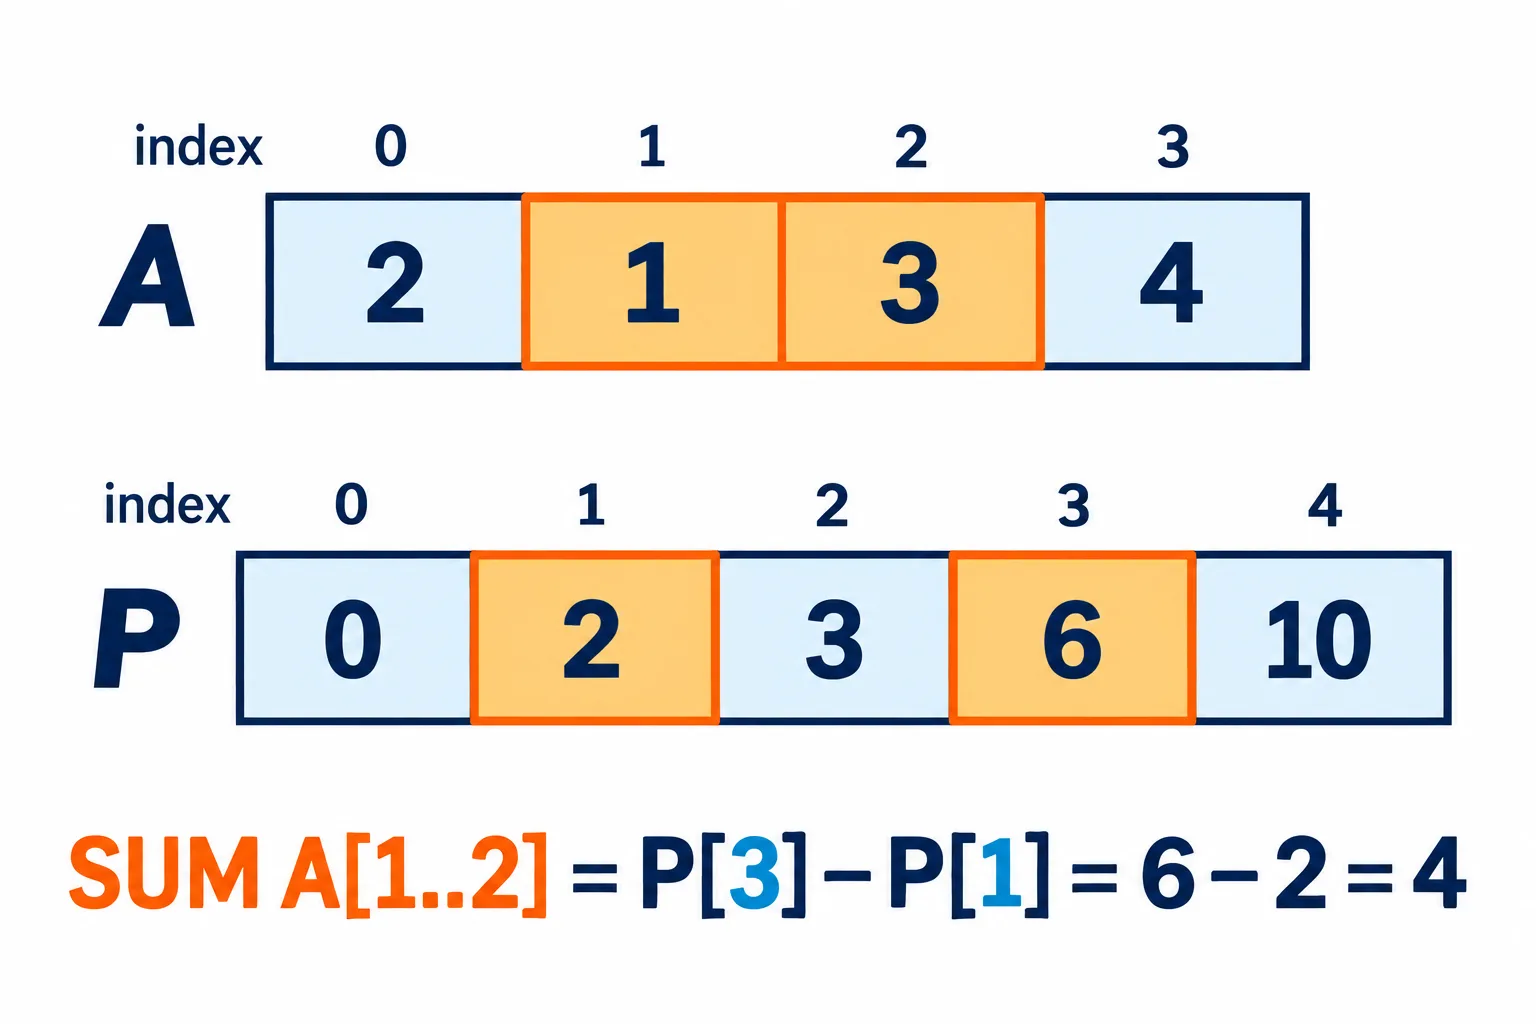
맨 앞에 0을 둔 누적 합에서는 구간 양 끝 경계의 값을 빼면 된다.
빈 접두 구간을 먼저 둔다
P[0]=0, P[i+1]=P[i]+A[i]로 정의하면 P[i]는 원소 i개, 즉 [0,i)의 합이다. 따라서 반열린 구간 [l,r)의 합은 P[r]-P[l]이다. 끝 인덱스를 포함하는 방식과 섞지 않아야 한다.
def build_prefix(values):
    prefix = [0] * (len(values) + 1)
    for index, value in enumerate(values):
        prefix[index + 1] = prefix[index] + value
    return prefix

def range_sum(prefix, left, right):
    if not 0 <= left <= right < len(prefix):
        raise ValueError("Invalid half-open range")
    return prefix[right] - prefix[left]

values = [3, -2, 5, 1]
prefix = build_prefix(values)
# prefix is [0, 3, 1, 6, 7]
# values[1:3] has sum prefix[3] - prefix[1] = 3
음수 원소가 있어도 덧셈과 뺄셈의 관계는 그대로 성립한다. l=r인 빈 구간은 0이 된다. 0을 앞에 넣지 않고 특별한 첫 구간 조건을 붙일 수도 있지만 인덱스 분기가 늘어난다.
빼기 가능한 집계라는 조건
전체 앞부분 P[r]에서 원하지 않는 앞부분 P[l]을 제거하면 남은 구간만 남는다. 합의 역연산이 빼기라서 가능한 일이다. XOR도 같은 구조를 사용할 수 있지만 최솟값은 앞부분 최솟값을 빼서 뒤 구간 최솟값을 얻을 수 없다.
질의가 q개라면 단순 순회는 최악 O(nq), 누적합은 O(n+q)다. 저장 공간은 O(n)이며 원본 배열을 그대로 보관할지는 별도 선택이다. 질의가 하나뿐이거나 입력이 스트리밍이라면 전처리의 이점이 다를 수 있다.
배열 원소 하나를 바꾸면 그 위치 뒤의 모든 누적값이 달라질 수 있다. 기본 누적합은 갱신에 O(n)이 필요하므로 빈번한 점 갱신에는 펜윅 트리나 세그먼트 트리가 적합하다. 질의가 빠르다는 장점은 데이터가 고정적일 때 특히 크다.
2차원 누적합은 왼쪽 위 직사각형 합을 저장한다. 원하는 사각형은 큰 접두 사각형에서 위쪽과 왼쪽을 빼고 두 번 뺀 겹침을 한 번 더하여 얻는다. 포함·배제 원리를 구현한 것이다.
합이 커지면 정수 오버플로를 확인해야 하고 부동소수점 누적은 반올림 오차가 생길 수 있다. 구간 표현, 수치 범위, 데이터 변경 빈도를 명시하면 짧은 공식이 실용적인 자료 처리 도구가 된다.
앞부분의 합이 작아도 두 큰 누적값의 차이를 구할 때 부동소수점 유효 자릿수를 잃을 수 있다. 정확한 정수 합과 근사 실수 합은 수치적 성질이 다르다.