다단계 피드백 큐는 작업의 행동을 보고 우선순위를 바꾼다
운영체제는 새 프로그램이 앞으로 CPU를 얼마나 오래 쓸지 정확히 모른다. 하지만 화면 입력을 처리하는 작업과 큰 계산을 계속하는 작업을 같은 방식으로 다루면 사용자 반응이 나빠질 수 있다. 다단계 피드백 큐, MLFQ는 여러 우선순위 큐를 두고 실제 실행 행동에 따라 작업을 이동시키는 스케줄링 아이디어다.
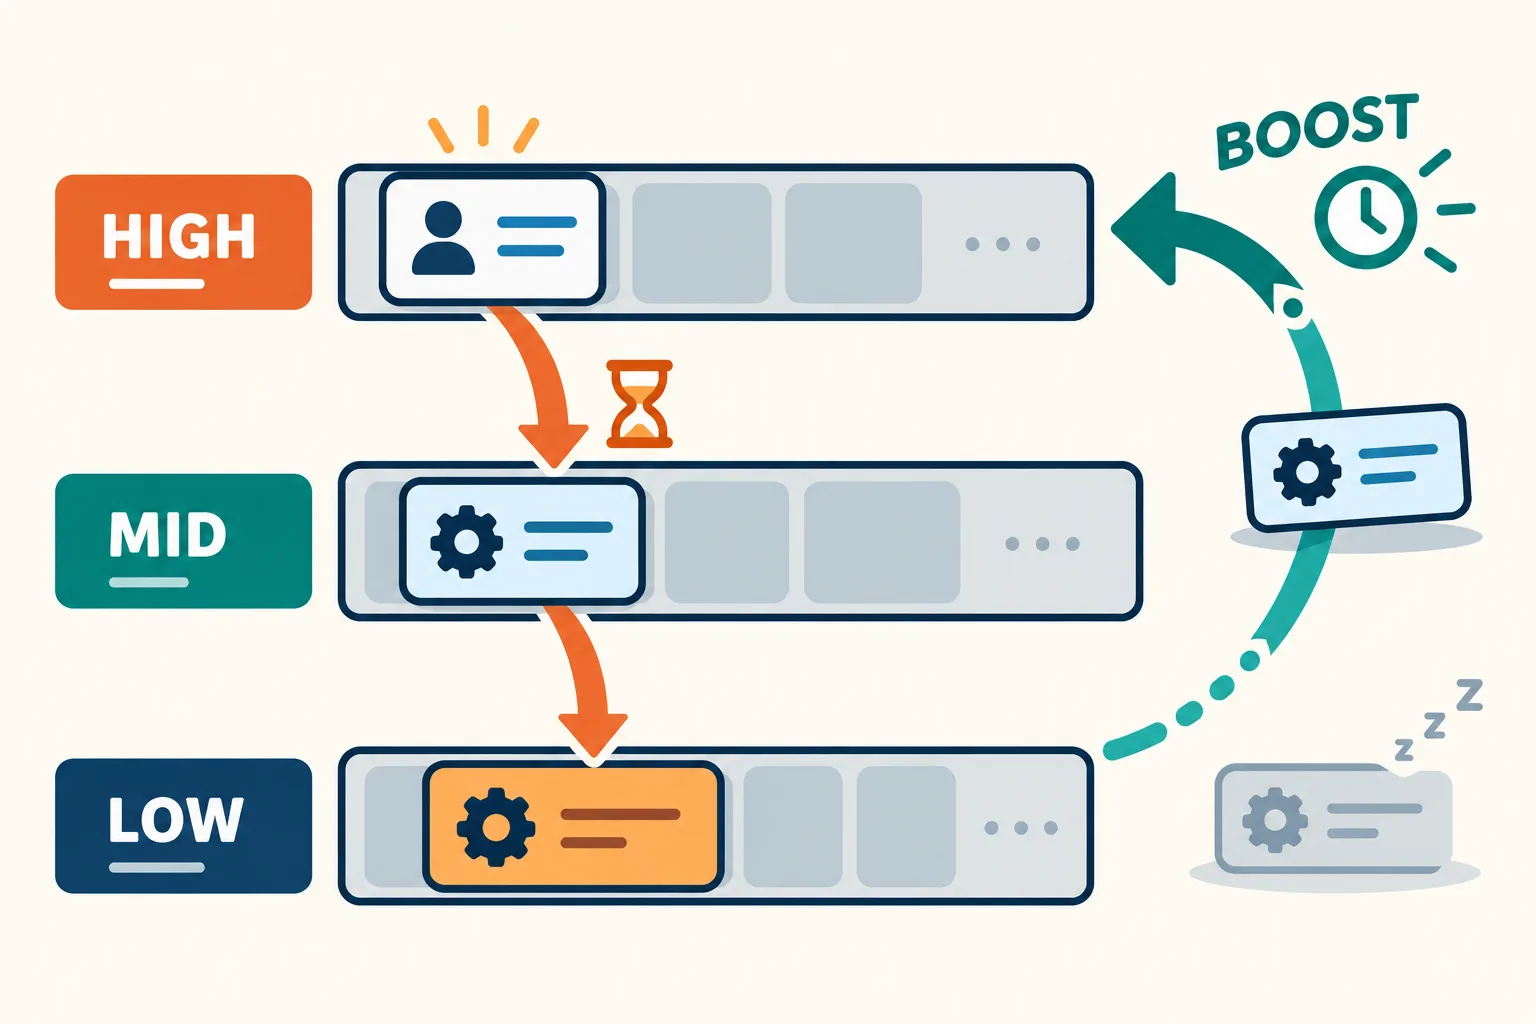
피드백은 작업의 실제 CPU 사용을 보고 우선순위를 조정한다.
처음에는 짧은 작업일 가능성을 준다
대표적인 교육용 모델에서는 새 작업을 높은 우선순위 큐에 둔다. 더 높은 큐에 준비 작업이 있으면 이를 먼저 실행하고, 같은 큐의 작업끼리는 라운드 로빈으로 차례를 돌린다. 한 우선순위에서 허용한 누적 CPU 시간을 쓰면 아래 큐로 이동시킨다. 실제 구현의 큐 수와 이동 규칙은 다양하다.
예를 들어 위쪽 큐의 허용량이 8ms, 중간 큐가 16ms라고 가정하자. 30ms 계산이 필요한 A는 처음 8ms를 쓴 후 내려가고, 중간에서 16ms를 더 쓴 후 가장 낮은 큐에서 남은 6ms를 처리한다. 새로 도착한 2ms짜리 B는 위쪽에서 빨리 끝날 가능성이 높다. 실행 길이를 미리 몰라도 관찰로 긴 작업을 구분하는 셈이다.
짧게 실행하고 기다리는 작업
입력 이벤트를 처리한 뒤 다시 기다리는 작업은 한 번의 CPU 사용이 짧다. 높은 우선순위를 유지하게 하면 새 입력에 빨리 반응할 수 있다. 그러나 대기를 했다는 사실만으로 언제나 새 허용량을 주면, 긴 계산을 하는 작업이 소진 직전마다 잠깐 양보해 높은 우선순위를 계속 얻을 수 있다. 정책은 실제 사용한 CPU 시간을 누적해서 이런 행동을 제한할 필요가 있다.
MLFQ에서 한 번의 시간 할당량과 해당 우선순위에서 쓸 수 있는 총 허용량은 구분할 수 있다. 전자는 한 차례를 얼마나 오래 실행하는지, 후자는 언제 큐를 내리는지를 정한다. OSTEP의 MLFQ 장은 누적 사용량 계산과 주기적인 우선순위 상승을 포함한 개선 규칙을 설명한다.
아래쪽 작업이 굶지 않으려면
높은 우선순위 작업이 계속 도착하면 아래 큐의 작업이 매우 오래 기다릴 수 있다. 이를 기아라고 한다. 일정 주기마다 작업들을 높은 우선순위로 올리는 부스팅은 실행 기회를 다시 주고, 과거에 계산 중심이었던 프로그램이 대화형 행동으로 바뀌었을 때 회복하는 데도 도움이 된다. 기다린 시간에 따라 우선순위를 조정하는 방법도 같은 목적을 가진다.
큐마다 다른 시간 할당량을 둘 수도 있다. 높은 큐는 짧게 실행해 응답성을 확보하고, 낮은 큐는 길게 실행해 전환 부담을 줄이는 식이다. 다만 부스팅 주기, 큐 수, 허용량을 잘못 설정하면 지연이나 관리 비용이 늘어난다. 작업의 과거 행동이 미래를 잘 예측하지 못하는 상황에서도 선택이 빗나갈 수 있다.
다단계 큐에 고정 배치하는 정책과 다단계 피드백 큐는 다르다. 피드백은 실행 결과를 보고 분류를 바꾼다는 의미다. 학습할 때는 작업의 CPU 사용량과 입출력 대기, 큐 이동, 부스팅을 시간선에 함께 표시하면 이해가 쉽다. 이 정책은 미래를 아는 최적 알고리즘을 구현하기보다, 불완전한 정보로 반응성과 효율을 조정하는 접근이다.