동적 배열: 빠른 인덱스 접근과 가끔 일어나는 복사의 대가
동적 배열은 연속된 메모리에 원소를 저장하면서 필요에 따라 저장 용량을 바꾸는 자료구조다. 논리적으로 들어 있는 원소 수인 길이와 실제 확보한 칸 수인 용량을 구분한다. 사용자는 크기가 늘어나는 배열처럼 보지만 내부에서는 다른 메모리 공간으로 옮기는 일이 일어난다.
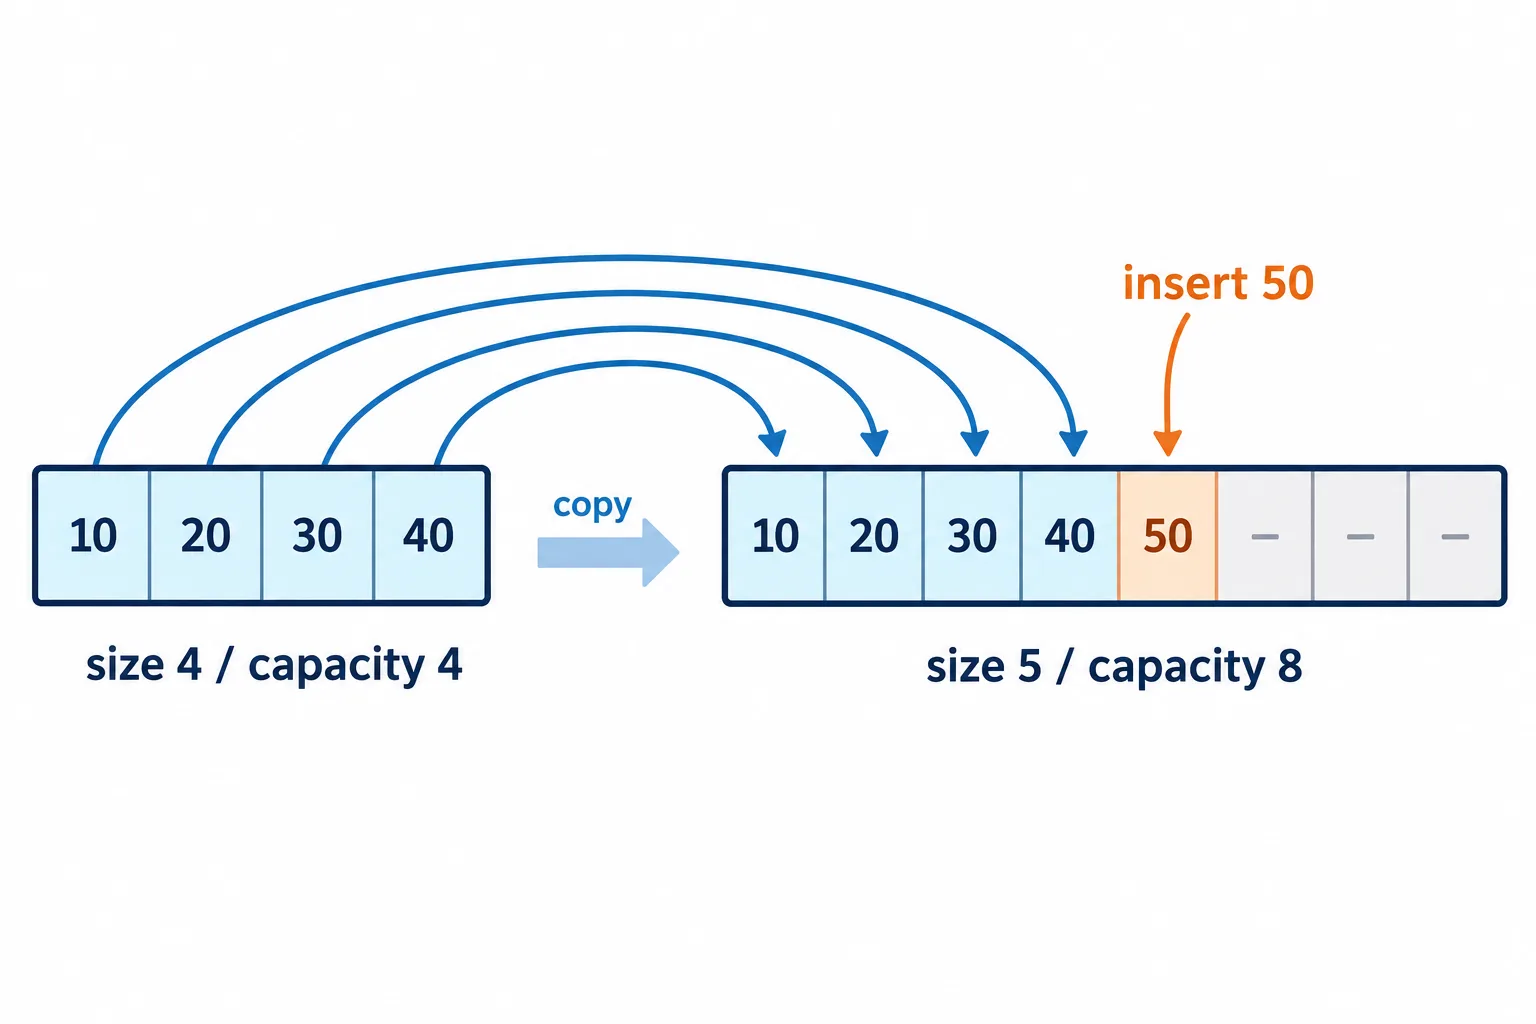
실제 원소 수인 크기와 확보된 저장 공간인 용량은 서로 다르다.
인덱스가 주소가 되는 구조
고정 크기 원소의 시작 주소가 B, 원소 크기가 s이면 i번째 원소 주소는 B+i×s다. 따라서 유효 범위 검사와 주소 계산 후 바로 접근하여 O(1) 시간을 기대할 수 있다. 앞에서부터 i개 원소를 따라갈 필요가 없다. 연속 배치는 공간 지역성이 좋아 순회에도 유리하다.
용량이 남아 있을 때 끝에 원소를 추가하면 현재 길이 위치에 값을 쓰고 길이를 하나 늘린다. 길이 4, 용량 4인 상태에서 다섯 번째 원소를 넣으려면 새로운 공간이 필요하다. 용량 8을 확보하고 기존 네 원소를 복사한 뒤 새 값을 넣는 것이 전형적인 정책이다.
새 공간의 주소는 기존 공간과 다를 수 있다. 그래서 언어와 컨테이너 규약에 따라 원소를 가리키던 포인터, 참조, 반복자가 무효화될 수 있다. 크기 변화가 논리적 원소 수만 바꾸는 일이 아니라 저장 위치까지 바꿀 수 있다는 뜻이다.
작업별 비용은 다르다
인덱스 접근은 O(1)이지만 가운데 삽입은 뒤 원소를 밀어야 하므로 O(n)이다. 삭제도 순서를 유지하려면 남은 원소를 당겨야 한다. 순서를 버려도 되는 경우 마지막 원소로 빈칸을 채울 수 있으나, 그때는 자료구조의 관찰되는 동작이 바뀐다.
용량을 일정 비율로 늘리면 끝 추가의 분할 상환 비용은 O(1)이다. 개별 확장 한 번은 O(n)이라는 사실과 모순되지 않는다. 용량을 매번 한 칸만 늘리면 누적 복사량이 O(n²)이 되어 좋은 보장이 사라진다.
용량을 크게 늘리면 재할당 횟수는 줄고 사용하지 않는 메모리는 늘어난다. 반대로 너무 작게 늘리면 복사가 잦다. 원소 삭제 시 즉시 축소하지 않는 구현도 많으며, 축소 임계값을 분리하면 추가·삭제 반복으로 확장과 축소가 번갈아 발생하는 문제를 줄인다.
입력 크기를 예상할 수 있다면 미리 용량을 예약해 큰 복사를 줄일 수 있다. 많은 중간 삽입이 필요한 작업, 안정된 원소 주소가 중요한 작업에는 다른 구조가 나을 수 있다. 자료구조를 고를 때는 평균 조회 비용만큼 변경 위치와 메모리 이동을 함께 봐야 한다.
재할당을 드러낸 교육용 모형
append(value):
    if length == capacity:
        new_capacity = max(1, capacity * 2)
        new_storage = allocate(new_capacity)
        for index in [0, length):
            new_storage[index] = old_storage[index]
        storage = new_storage
        capacity = new_capacity
    storage[length] = value
    length = length + 1
길이가 0이고 용량도 0인 초기 상태에서 단순히 두 배만 하면 계속 0이다. 최소 용량 1이라는 조건이 첫 추가를 가능하게 한다. 원소가 객체라면 여기서 복사하는 것이 객체 본체인지 참조인지도 언어의 컨테이너 의미에 따라 달라진다.