디스크 페이지를 적게 읽는 탐색 구조: B+ 트리
B+ 트리는 데이터베이스 인덱스에서 널리 쓰이는 균형 탐색 트리다. 한 노드가 여러 키와 자식 포인터를 담아 높은 분기수를 갖고, 실제 데이터 항목 또는 그 위치는 리프에 모아 둔다. 내부 노드는 탐색 방향을 안내한다. 메모리에서 비교 횟수만 줄이는 것보다 저장장치의 페이지 접근 횟수를 줄이는 데 중요한 구조다.
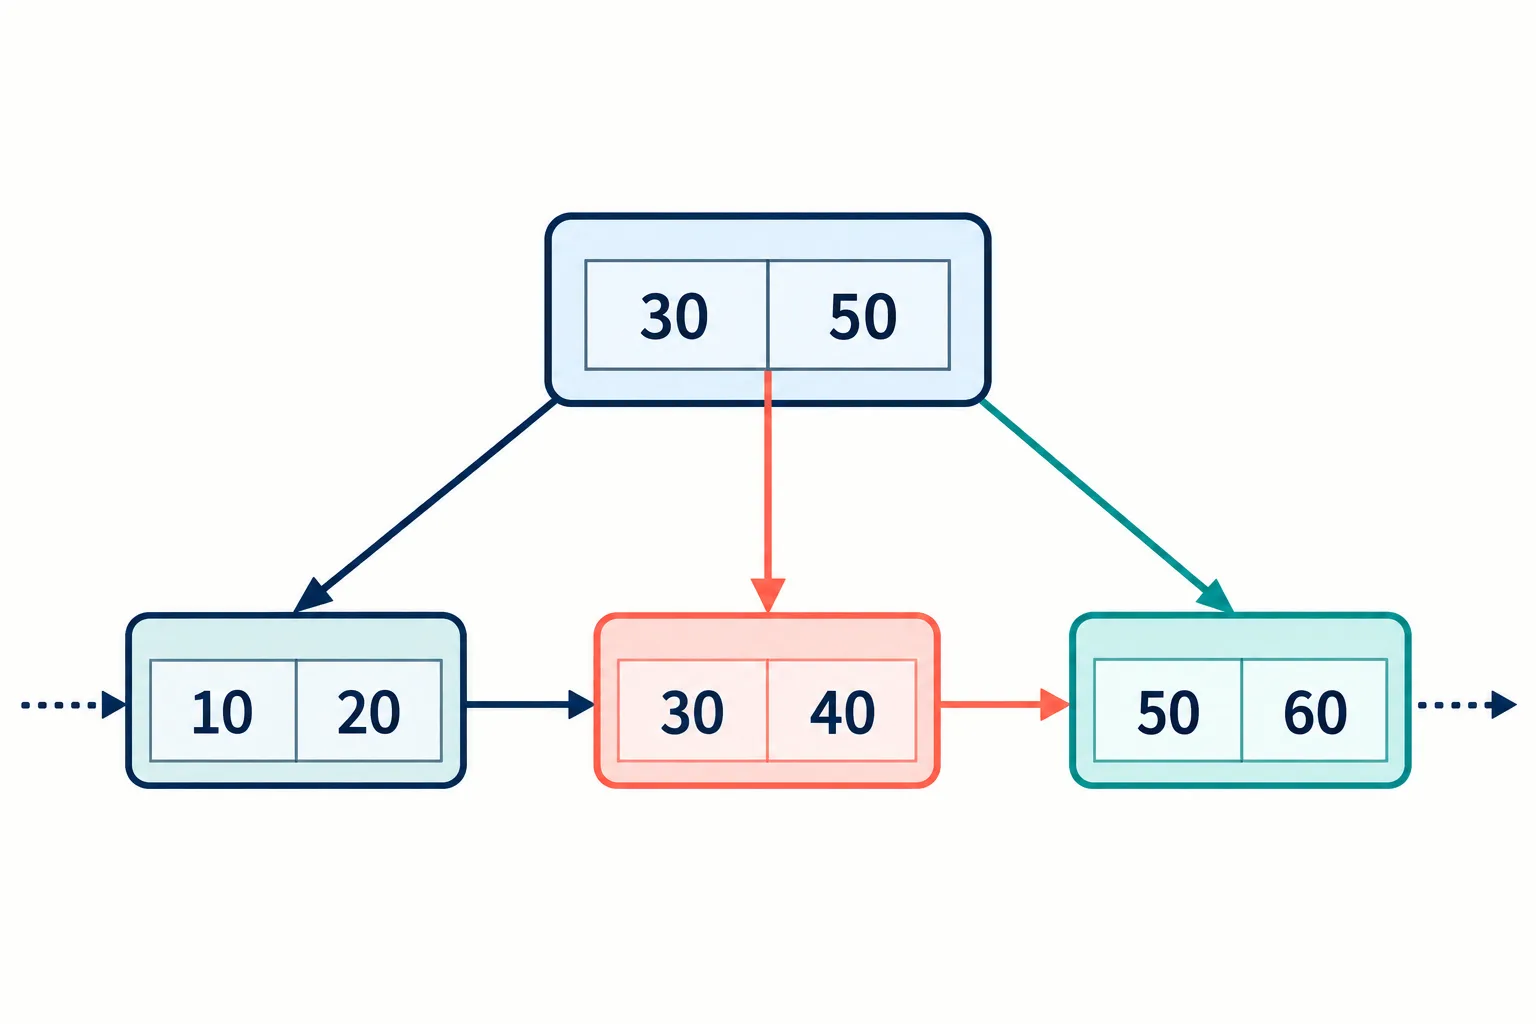
높은 분기수는 탐색 깊이를 줄이고 리프 연결은 범위 순회를 돕는다.
한 번 읽은 페이지에서 많은 길을 고른다
이진 트리는 노드마다 보통 두 갈래를 선택하지만 B+ 트리의 노드는 하나의 페이지에 많은 키를 담을 수 있다. 내부 키들은 자식들이 담당하는 범위의 경계를 표현한다. 찾을 키와 경계를 비교하여 자식 하나로 내려가고, 모든 리프가 같은 깊이를 유지하므로 특정 키만 유난히 긴 경로를 갖지 않는다.
분기수가 대략 f이고 키가 N개인 단순 모델에서는 높이가 로그 f의 N에 비례한다. f가 크면 많은 키를 가진 인덱스도 비교적 적은 페이지를 거쳐 리프에 도달할 수 있다. 하지만 실제 높이는 키 크기, 포인터 크기, 페이지 크기와 노드의 채워진 정도에도 영향을 받는다. 큰 문자열을 키에 추가하면 분기수가 줄어드는 이유다.
범위를 찾은 뒤에는 옆으로 간다
학번 120부터 180까지 찾는 질의를 생각해 보자. 우선 루트에서 시작하여 120이 들어갈 리프를 찾는다. 그 리프 안에서 시작 위치를 확인하고, 다음 키들을 읽다가 리프 끝에 도달하면 옆 리프로 이동한다. 리프가 키 순서로 연결되어 있기 때문에 구간의 매 키마다 루트로 돌아가 다시 탐색하지 않아도 된다.
단일 키를 찾는 비용과 많은 결과를 반환하는 비용은 구분해야 한다. 탐색 높이가 작아도 결과가 십만 개면 그 항목들을 읽고 반환하는 비용은 남는다. 인덱스의 리프가 테이블 행 위치를 담는 경우에는 실제 행을 읽는 추가 접근도 필요할 수 있다. 트리의 높이만으로 전체 쿼리 시간을 예측할 수는 없다.
새 키를 넣을 리프에 공간이 없으면 노드를 분할하고 상위 노드에 새 경계와 포인터를 반영한다. 상위 노드도 꽉 차면 분할이 위로 이어질 수 있고, 루트가 분할되면 높이가 늘어난다. 삭제 시에는 구현 정책에 따라 재분배나 병합 등을 수행해 구조와 공간 사용을 관리한다.
동시에 여러 작업이 트리를 수정할 때는 페이지와 구조의 일관성을 보호해야 한다. 분할 도중 다른 독자가 잘못된 경로를 따라가지 않도록 짧은 동기화와 탐색 규칙을 사용한다. 이것은 업무 트랜잭션의 격리를 위한 잠금과 같은 이름으로 뭉뚱그리기보다, 내부 자료구조를 안전하게 읽고 고치는 책임으로 구분하는 편이 좋다.
B 트리와 B+ 트리는 관련된 구조지만 같은 세부 형태를 뜻하지 않는다. B+ 트리에서는 내부 노드의 안내 키와 리프의 데이터 항목을 구분하는 것이 핵심이다. 실제 제품 문서에서 B-tree라는 이름을 넓은 계열명으로 사용하는 경우도 있어, 이름만으로 내부 구현을 단정하지 않는 것이 좋다.
페이지가 대부분 비어 있거나 키가 특정 구간에 몰리면 공간 효율과 수정 부하가 달라질 수 있다. 순차 삽입은 특정 리프에 작업이 집중되기도 한다. B+ 트리를 평가할 때는 탐색 깊이, 범위 스캔 길이, 분할 빈도와 쓰기 동시성을 함께 본다. 높은 분기수와 연결된 리프라는 두 특징이 점 조회와 범위 조회를 어떻게 돕는지 설명할 수 있으면 구조의 목적을 이해한 것이다.