명령어 파이프라인은 한 명령의 시간보다 처리량을 바꾼다
CPU가 명령을 실행하려면 명령을 가져오고, 해석하고, 계산하고, 필요한 메모리를 접근하고, 결과를 기록하는 일을 해야 한다. 명령어 파이프라인은 이런 단계를 나누어 서로 다른 명령의 작업을 겹치는 구조다. 공장에서 여러 제품이 다른 공정을 동시에 지나는 것처럼 한 명령을 처리하는 동안 다음 명령도 앞 단계에서 진행하게 한다.
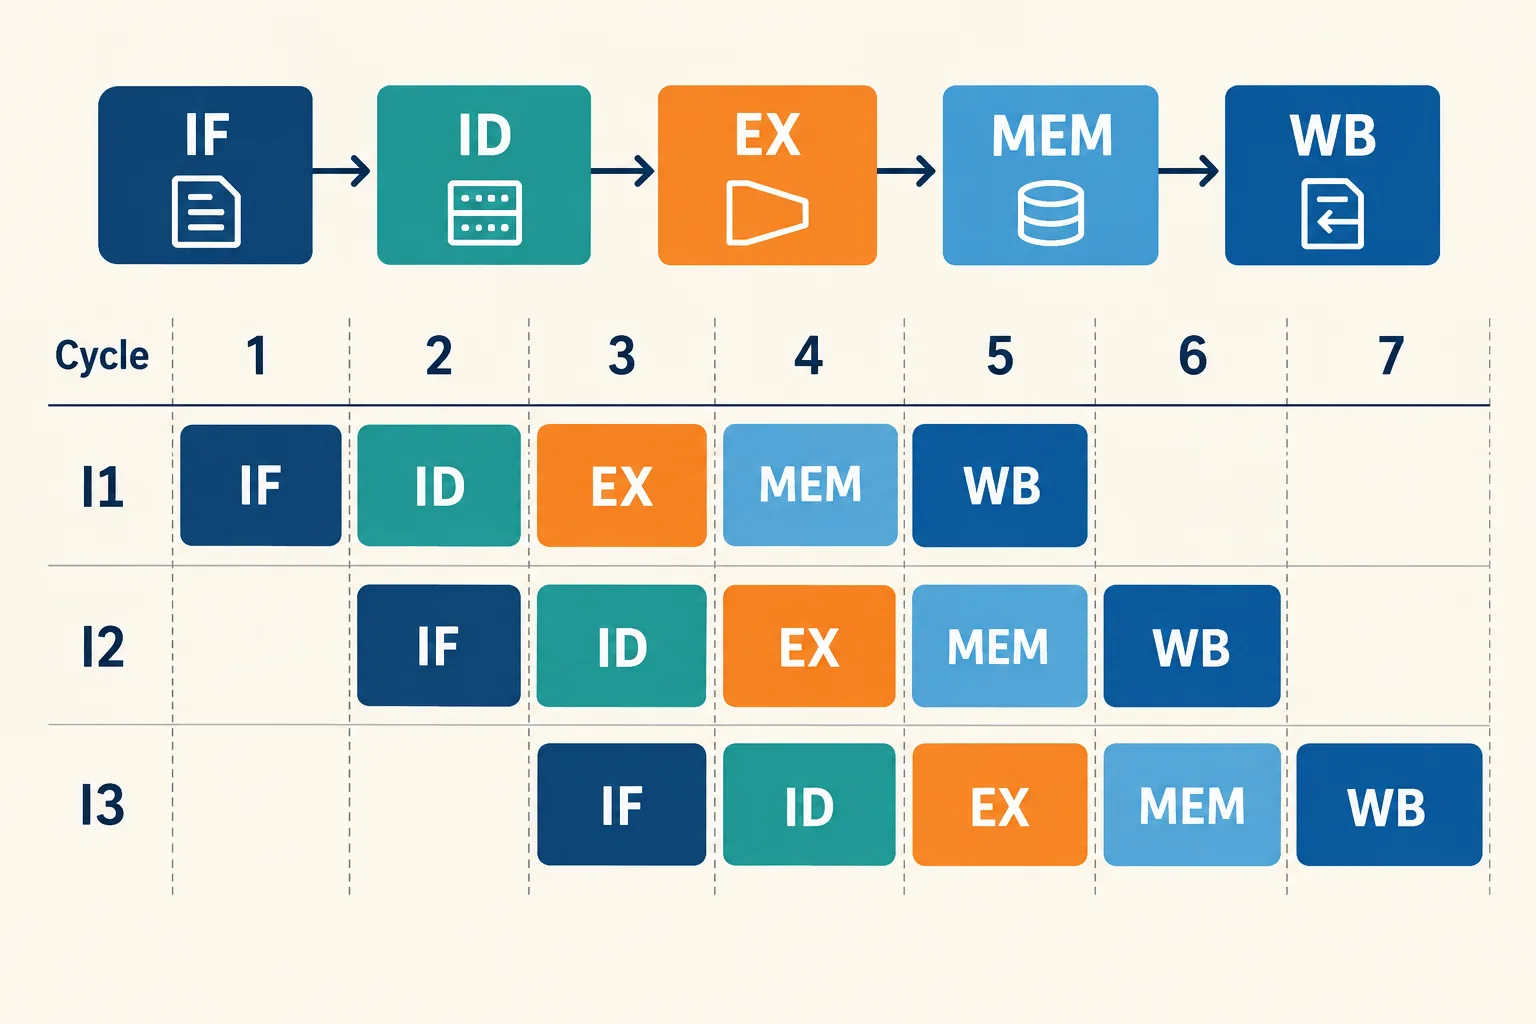
한 명령의 지연 시간과 전체 명령의 완료 처리량은 서로 다르다.
지연 시간과 처리량은 다르다
교육용으로 다섯 단계가 각각 한 사이클 걸리는 CPU를 생각해 보자. 명령 하나는 시작부터 완료까지 여전히 다섯 단계를 지난다. 하지만 파이프라인이 채워진 뒤에는 매 사이클 한 명령이 완료될 수 있다. 한 명령의 지연 시간이 다섯 사이클이라는 말과 처리량이 사이클당 한 명령이라는 말은 동시에 성립한다.
서로 독립적인 명령 N개를 끊김 없이 처리하는 이상적인 모델에서는 다섯 단계 파이프라인에 N+4사이클이 필요하다. 처음 채우는 네 사이클 뒤부터 완료가 이어지기 때문이다. 단계별 작업을 매번 모두 끝낸 뒤 다음 명령을 시작하는 5N사이클 모델과 비교할 수 있다. 같은 단계 시간과 부가 비용 무시라는 가정이 필요한 계산이며 실제 CPU 속도를 그대로 예측하는 식은 아니다.
단계 사이에 기록을 둔다
각 단계의 결과는 파이프라인 레지스터 등으로 보관해 다음 사이클에 다음 단계가 사용한다. 단계별 작업 시간이 크게 다르면 가장 느린 단계가 클럭 주기의 제한이 된다. 작업을 더 세분해도 레지스터 지연과 제어 비용이 추가된다. MIT의 기본 5단계 파이프라인 수업은 단계 겹침과 구현을 설명한다.
명령이 모두 같은 유용한 일을 수행하는 것은 아니다. 어떤 명령은 데이터 메모리 접근이 필요 없고, 어떤 명령은 분기 목적지를 계산한다. 교육용 모델은 일정한 단계 흐름을 보여 주지만 실제 구현의 단계 수와 이름, 완료 규칙은 다양하다. 다섯 단계라는 숫자를 모든 CPU의 공통 사실로 외우면 안 된다.
겹쳐 실행하면 의존성이 드러난다
앞 명령의 덧셈 결과를 바로 다음 명령이 사용한다면 결과가 준비되는 시점과 읽는 시점이 맞아야 한다. 기다리는 스톨이나 결과 전달 경로가 필요할 수 있다. 분기에서는 다음에 가져올 명령의 주소가 아직 확정되지 않을 수 있다. 실행 장치나 메모리 포트를 두 명령이 동시에 원하면 자원 충돌도 생긴다. 이런 문제를 해저드라고 부른다.
파이프라인을 깊게 하면 더 짧은 단계로 높은 클럭을 노릴 수 있지만, 잘못 예측한 분기 뒤에 버려야 할 작업과 복구 부담이 커질 수 있다. 명령 하나가 지나는 단계도 늘어 지연 시간이 길어질 수 있다. 단계 수의 증가를 곧바로 속도 증가로 해석할 수 없는 이유다.
성능을 볼 때는 명령 수, 사이클당 명령 수, 클럭 주기를 함께 고려한다. 같은 코드도 메모리 대기와 의존 사슬이 많으면 이상적인 처리량에 도달하지 못한다. 파이프라인의 목적은 명령 하나를 마법처럼 즉시 끝내는 것이 아니라, 여러 명령의 서로 다른 작업을 겹쳐 전체 처리량을 높이는 데 있다.