병합 정렬: 정렬된 두 구간을 합치는 일이 핵심인 이유
병합 정렬은 배열을 작은 구간으로 나누어 각각 정렬한 뒤 합치는 알고리즘이다. 길이 0이나 1인 구간은 이미 정렬되어 있다. 큰 구간의 순서는 정렬된 두 부분의 앞 원소를 비교하며 만드는 병합 단계에서 완성된다.
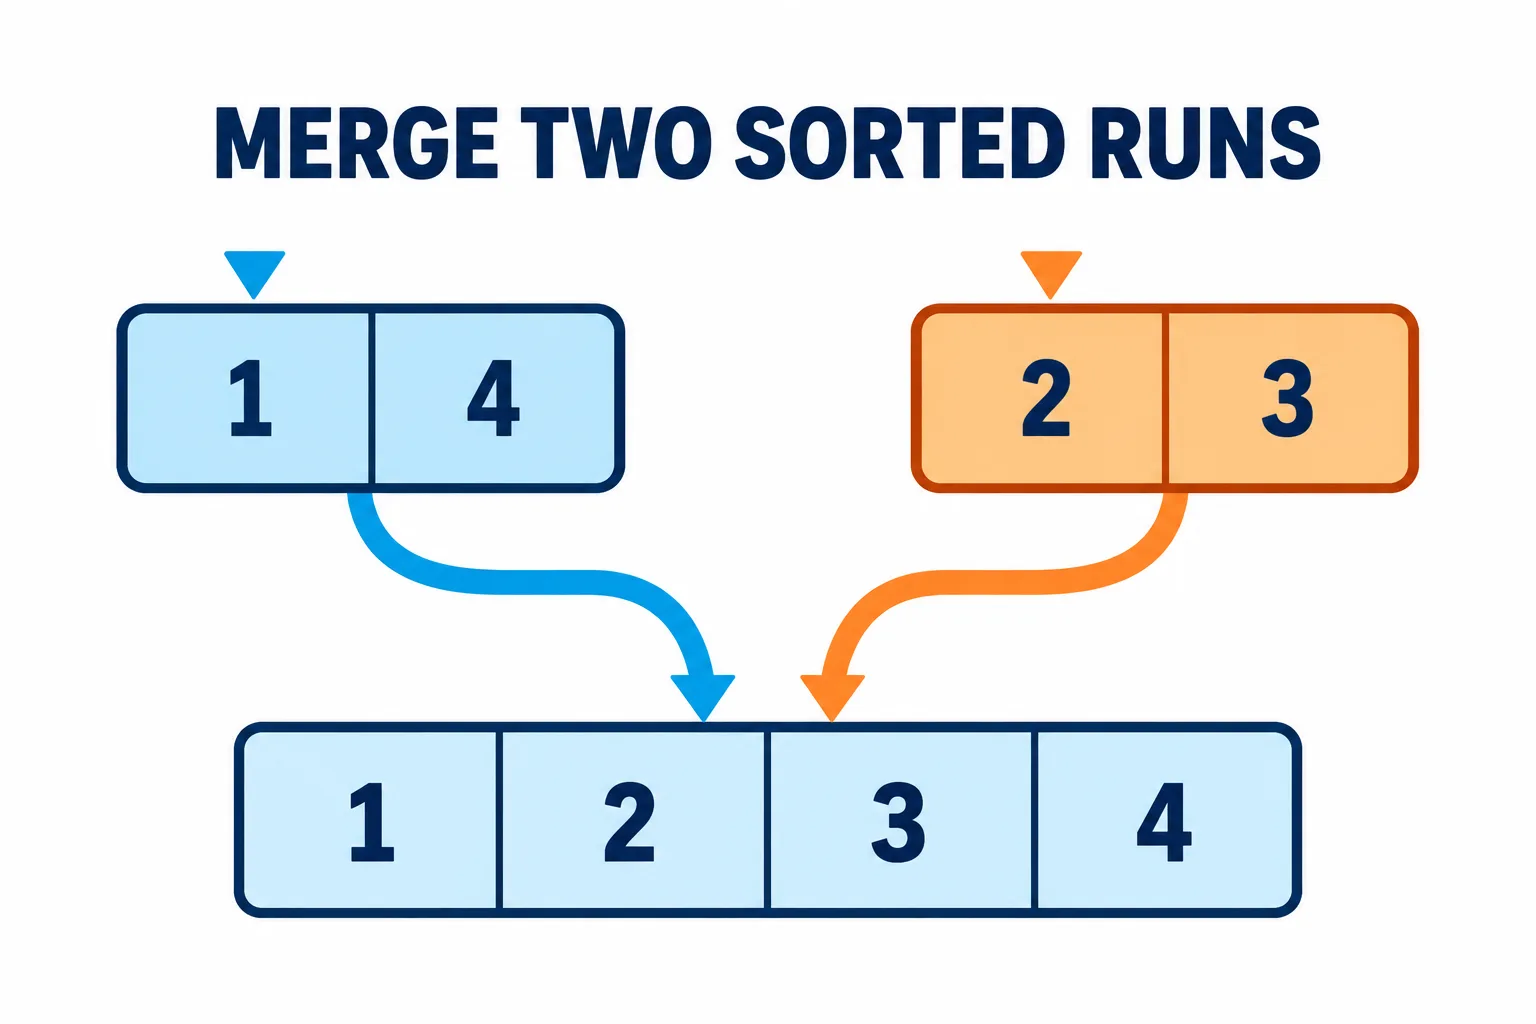
각 입력 구간의 선두를 비교해 더 작은 원소를 결과에 넣는다.
앞 원소끼리 비교하면 되는 이유
왼쪽이 [2,6,8], 오른쪽이 [1,3,7]이면 전체 최솟값은 두 구간의 앞 2와 1 중 하나다. 1을 꺼낸 뒤에도 같은 논리가 남은 두 정렬 구간에 적용된다. 한 구간이 비면 다른 구간의 나머지를 그대로 이어 붙인다.
def merge_sorted(left_values, right_values):
    left_index = right_index = 0
    merged = []
    while left_index < len(left_values) and right_index < len(right_values):
        if left_values[left_index] <= right_values[right_index]:
            merged.append(left_values[left_index])
            left_index += 1
        else:
            merged.append(right_values[right_index])
            right_index += 1
    merged.extend(left_values[left_index:])
    merged.extend(right_values[right_index:])
    return merged
출력한 구간은 항상 정렬되어 있고, 아직 출력하지 않은 최솟값은 두 앞 위치 중 하나다. 이 불변식이 병합의 정확성을 설명한다. 위 코드는 원소 자체로 비교하지만 레코드 정렬에서는 별도 키를 사용할 수 있다.
안정성은 동률 처리에서 결정된다
키가 같을 때 왼쪽 원소를 먼저 꺼내면 원래 입력에서 먼저 있던 원소의 상대 순서를 유지한다. 전체 재귀가 같은 규칙을 쓰면 안정 정렬이 된다. 비교를 '<'만 쓰고 오른쪽을 먼저 선택하면 전형적인 구현의 안정성이 사라질 수 있다.
각 층의 병합 총량은 n이고 분할 층은 O(log n)이어서 최악·평균 모두 Θ(n log n)이다. 비교 기반 정렬로서 예측 가능한 비용이 장점이다. 정렬된 입력에서도 보통 병합 작업이 수행되지만, 구현에 따라 이미 정렬된 경계를 검사해 건너뛸 수 있다.
배열 기반 표준 구현은 O(n) 보조 공간이 필요하고 재귀 스택도 O(log n)이 든다. 모든 재귀 단계마다 슬라이스와 새 배열을 만들어도 시간의 큰 차수는 같을 수 있지만 할당과 복사의 상수 비용은 커진다. 재사용 버퍼와 인덱스 범위로 이를 줄일 수 있다.
연결 리스트는 원소를 이동하는 대신 연결을 바꿔 병합할 수 있어 배열과 공간 특성이 다르다. 디스크에 저장된 큰 데이터를 여러 정렬 묶음으로 나누고 순차 병합하는 외부 정렬에도 구조가 잘 맞는다.
병합 정렬은 안정성과 최악 시간 보장이 필요할 때 좋은 선택이다. 그러나 “병합”이라는 이름만으로 제자리 정렬이 되거나 모든 구현이 안정적인 것은 아니다. 데이터 표현, 동률 선택, 보조 저장 방식이 구체적인 성질을 결정한다.