복제: 사본을 늘리면 신뢰성도 자동으로 높아질까
복제는 같은 논리적 데이터를 여러 노드에 보관하는 방식이다. 한 노드가 멈춰도 다른 사본을 사용할 수 있고 읽기 부하를 나눌 수 있다. 하지만 사본 수를 늘리는 일과 사본들이 같은 의미의 상태를 유지하는 일은 별개의 과제다. 쓰기를 어떤 순서로 전달하고 언제 성공으로 응답할지 정해야 한다.
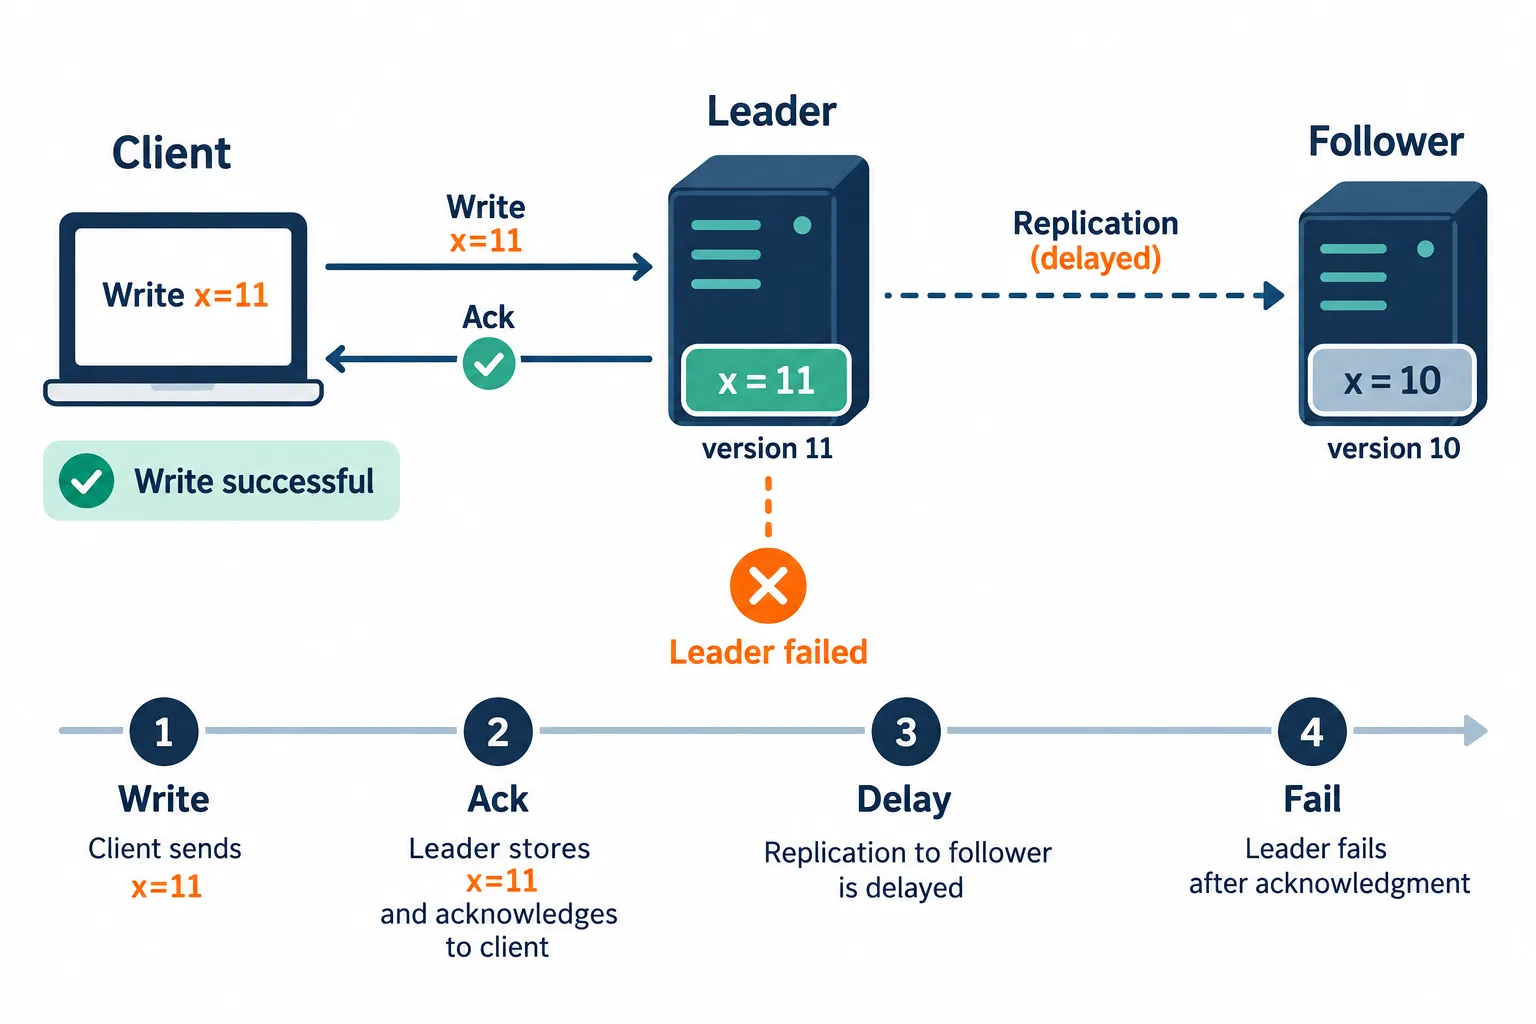
복제의 내구성은 사본 개수뿐 아니라 성공 응답 전에 무엇을 확인하는지에 달려 있다.
리더와 팔로워가 나누는 역할
단일 리더 방식에서는 쓰기를 리더가 받아 순서를 정하고 팔로워에 전파한다. 각 사본이 같은 연산열을 같은 순서로 적용하면 같은 상태를 얻을 수 있다. 실행 결과가 시각이나 난수 같은 외부 요소에 의존한다면 그 입력도 함께 기록해야 일치한다.
비동기 복제는 리더의 저장이 끝나면 팔로워 완료를 기다리지 않고 응답할 수 있다. 응답은 빠르지만 팔로워가 뒤처질 수 있다. 동기 방식은 지정된 사본의 확인을 기다리며, 어떤 사본의 어떤 저장 단계까지 확인할지에 따라 지연과 장애 보장이 달라진다.
Initial state: leader version 10, follower version 10
1. Client sends update 11 to leader.
2. Leader records update 11.
3. Leader reports success to client.
4. Replication message to follower is delayed.
5. Leader fails; follower still has version 10.
위 흐름에서 팔로워를 새 리더로 만들면 사용자가 성공 응답을 받은 갱신이 보이지 않을 수 있다. 응답 전에 다른 노드의 영속 저장까지 기다리는 정책은 이 위험을 줄이지만, 그 노드가 느리거나 통신이 끊기면 쓰기가 기다리게 된다.
장애 뒤 리더 교체도 규칙이 필요하다
리더가 응답하지 않는 이유는 실제 중단일 수도 있고 네트워크 지연일 수도 있다. 이전 리더가 계속 살아 있는 동안 새 리더를 임명하면 둘이 동시에 쓰기를 받는 문제가 생긴다. 임기 번호, 쿼럼, 합의, fencing 같은 방식으로 오래된 권한의 효과를 막아야 한다.
복제 지연은 팔로워 읽기에도 영향을 준다. 사용자가 방금 쓴 값을 바로 조회하려면 리더 읽기, 최소 버전까지 대기, 세션 토큰 같은 보완책을 사용할 수 있다. 여러 사본이 있다는 사실만으로 최신 읽기가 보장되지 않는다.
사본 간 전달이 빠르더라도 같은 전원, 같은 디스크 장애, 같은 잘못된 삭제 요청을 함께 겪을 수 있다. 복제는 백업과 같지 않다. 잘못된 갱신이 모든 사본에 전파되면 과거 시점 복구를 위한 별도 기록이 필요하다.
읽기 확장, 장애 허용, 지역 접근 지연 감소가 대표적 목적이다. 쓰기 경로, 승인 조건, 복제 지연, 장애 영역, 복구 절차를 함께 설계해야 목적에 맞는 신뢰성이 생긴다. 특히 “저장했다”는 표현이 메모리 기록인지 디스크 영속화인지 구분되어야 실패 뒤의 보장을 정확히 말할 수 있다.
복제 확인을 받은 노드가 데이터를 메모리에만 두었다면 동시에 재시작할 때 잃을 수 있다. 사본의 응답과 영속 저장의 응답을 구분하는 것이 실패 모델의 핵심이다.