부동소수점: 0.1을 그대로 저장하기 어려운 이유
부동소수점은 제한된 비트로 매우 작거나 큰 수를 함께 나타내기 위해 유효 숫자와 크기 척도를 분리하는 표현이다. 과학적 표기에서 1.25×10^6처럼 숫자 부분과 지수를 나누는 것과 닮았다. 흔히 쓰는 이진 형식은 부호, 지수, 유효 숫자 관련 비트를 보관한다. 표현 범위가 넓지만 모든 실수를 정확히 담을 수 있는 것은 아니다.
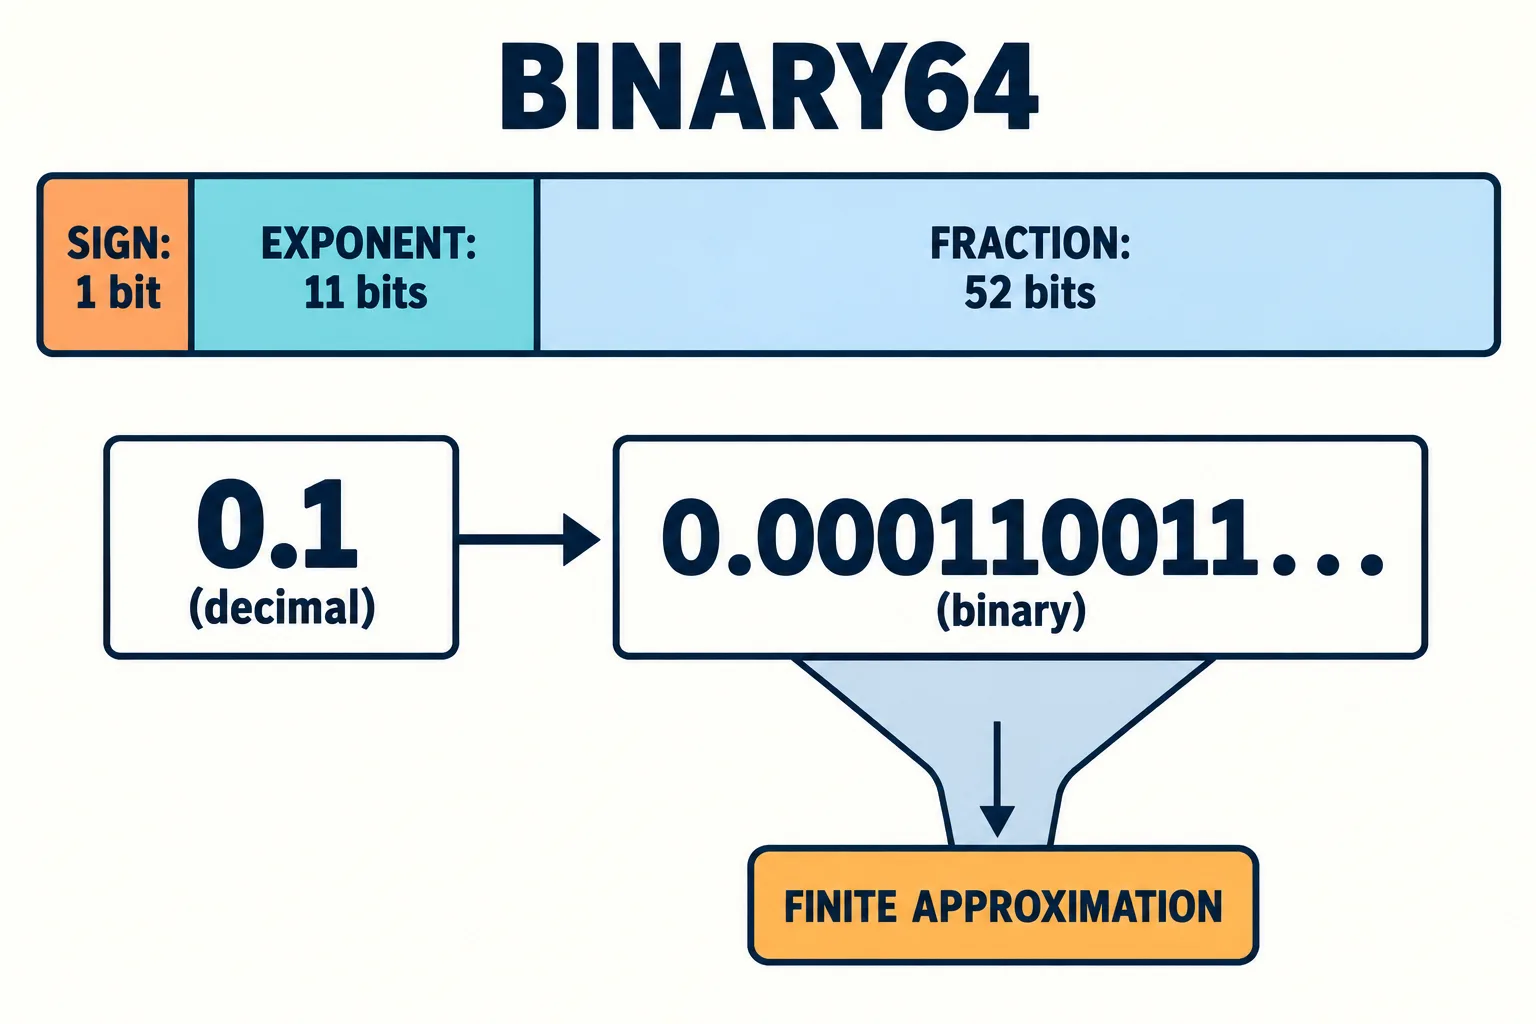
유한한 비트로 저장할 수 있는 이진 값만 선택하므로 일부 십진 소수는 근사가 된다.
이진 분수에도 끝나지 않는 수가 있다
0.5는 이진수에서 0.1, 0.25는 0.01이므로 유한하게 표현할 수 있다. 그러나 0.1은 이진 분수로 무한히 반복된다. 한정된 비트에서는 가까운 표현 가능한 수를 선택해야 한다. Python의 부동소수점 설명은 입력한 십진수와 내부 이진 근사값, 출력 시 다시 반올림한 문자열의 차이를 설명한다.
화면에 0.1이라고 표시돼도 내부 값이 수학적인 1/10과 정확히 같다는 뜻은 아니다. 반대로 긴 소수 문자열이 출력됐다고 연산 전체가 무작위로 망가진 것도 아니다. 표현 가능한 수와 정해진 반올림 규칙에 따라 생긴 차이다. 입력 변환, 각 연산의 반올림, 최종 표시를 구분하면 어디서 근사가 들어갔는지 읽을 수 있다.
정밀도는 수의 크기와 함께 달라진다
IEEE 754의 binary64는 부호 1비트, 지수 11비트, 분수 필드 52비트를 사용한다. 정상적인 수에서는 숨은 선행 비트까지 유효 정밀도에 참여한다. 지수가 커질수록 인접한 표현 값 사이의 절대 간격도 커진다. 같은 형식이라도 1 근처에서 구분할 수 있는 작은 차이와 아주 큰 수 근처에서 구분할 수 있는 차이는 다르다.
그 결과 덧셈은 수학적 실수처럼 항상 결합적이지 않다. binary64의 일반적인 반올림에서 (1e16 + -1e16) + 1은 1이지만 1e16 + (-1e16 + 1)은 0이 될 수 있다. 두 번째 식의 작은 1이 큰 값의 간격 때문에 먼저 사라지기 때문이다. 계산 순서를 바꾸는 최적화나 병렬 합산이 결과를 바꿀 수 있다는 구체적인 예다.
특별한 패턴도 의미가 있다
IEEE 754는 0, 아주 작은 비정규 수, 무한대, NaN 같은 값을 구분한다. NaN은 수로 표현할 수 없는 결과 등을 나타내며, 일반적인 비교에서 자기 자신과의 같음도 성립하지 않는다. 특수 값은 단순한 오류 문자열이 아니라 연산 규칙에 참여한다. 입력 범위를 검사하고 결과가 유한한지 확인해야 하는 계산에서는 이 규칙이 중요하다.
근사값 비교에는 절대 오차와 상대 오차를 목적에 맞게 사용한다. 0 근처에서는 상대 비율만으로 판단하기 어렵고, 큰 수에서는 고정 절대 오차만으로 허용 범위를 잡기 어렵다. 임의로 모든 결과에 같은 작은 상수를 적용하면 프로그램의 실제 요구와 맞지 않을 수 있다. 측정 오차와 수치 오차, 도메인이 허용하는 차이를 구분해야 한다.
정확한 십진 소수 처리가 필요하면 십진 연산 형식을, 분수 관계가 중요하면 유리수 표현을 검토할 수 있다. 이들 역시 연산 비용과 정밀도 설정 등 다른 선택이 있다. 부동소수점이 잘못된 표현이라는 뜻은 아니며 과학 계산과 그래픽 등에서 넓은 범위와 효율이 매우 유용하다.
부동소수점을 다룰 때는 표현 형식, 반올림, 계산 순서, 오차 기준을 함께 정한다. 특히 큰 수와 작은 수를 섞거나 거의 같은 값을 빼는 계산은 정보 손실에 주의해야 한다. 유한한 비트로 실수 계산을 근사한다는 관점이 예상 밖의 끝자리와 안정적인 수치 알고리즘을 연결해 준다.