분리 집합: 그룹을 합치고 소속을 빠르게 판별하기
분리 집합은 겹치지 않는 여러 집합을 관리하며 두 원소가 같은 그룹에 속하는지 판별하는 자료구조다. union-find라고도 한다. 원소의 순서나 집합 내부 목록보다, 그룹의 대표와 그룹 간 합치기를 효율적으로 처리하는 데 초점을 둔다.
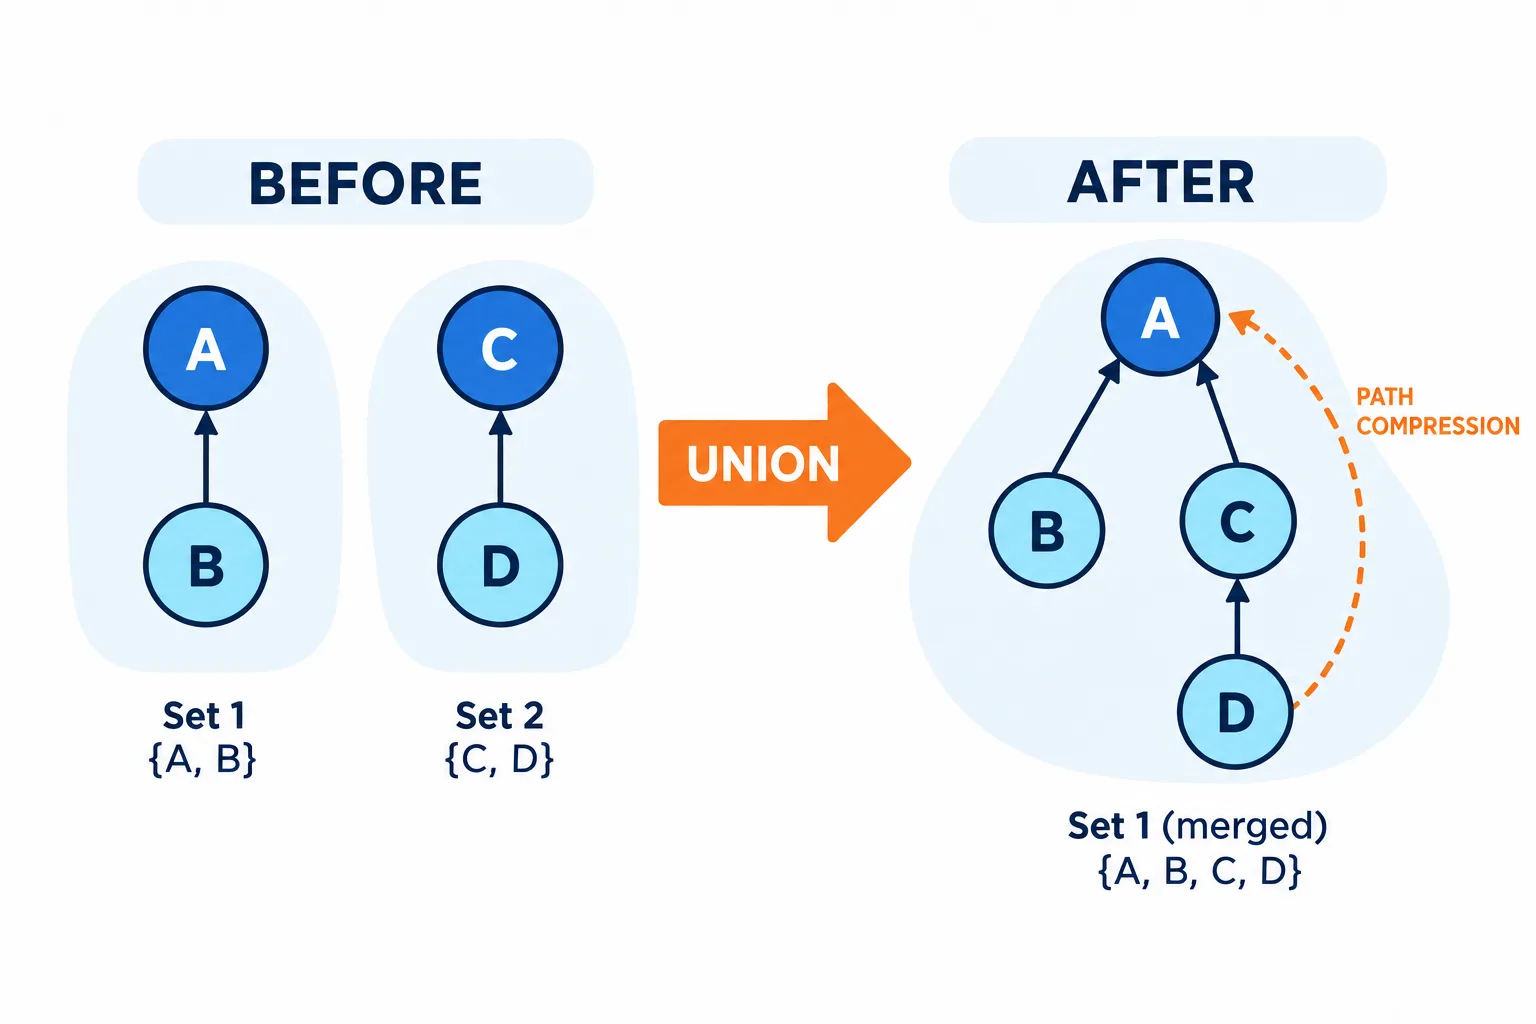
실선 화살표는 자식에서 부모로 향하며, 경로 압축은 같은 집합의 루트로 직접 연결한다.
대표 원소를 부모 사슬로 찾기
각 원소에 parent를 두고 루트는 자신을 부모로 가리킨다. find(x)는 루트까지 따라가 대표를 반환한다. 두 원소의 대표가 같으면 같은 집합이다. union(a,b)는 두 대표가 다를 때 한 루트를 다른 루트 아래에 붙인다.
A와 B를 합치고 C와 D를 합친 뒤 B와 C를 합치면 네 원소가 한 그룹이 된다. B와 C만 연결한 것으로 생각하면 안 된다. 각 원소의 대표를 찾아 두 집합 전체를 하나로 만드는 연산이다.
작은 트리를 큰 트리에 붙인다
다음은 경로 압축과 크기 기준 합치기를 사용한 예다. parent와 size는 처음에 각 원소가 단독 집합인 상태로 초기화되어 있다고 가정한다.
def find(element):
    if parent[element] != element:
        parent[element] = find(parent[element])
    return parent[element]

def union(first, second):
    root_a, root_b = find(first), find(second)
    if root_a == root_b:
        return False
    if size[root_a] < size[root_b]:
        root_a, root_b = root_b, root_a
    parent[root_b] = root_a
    size[root_a] += size[root_b]
    return True
경로 압축은 find가 지나간 노드의 부모를 대표로 직접 바꾼다. 다음 조회는 더 짧은 길로 간다. 크기 기준 결합은 작은 트리를 큰 트리에 붙여 나쁜 사슬이 생기는 것을 막는다. 크기 값은 대표 노드에서만 의미 있게 관리하면 된다.
두 최적화를 함께 쓰면 연속 연산의 분할 상환 비용은 역 아커만 함수 α(n)에 비례한다. 실용 범위에서는 매우 작지만 엄밀하게 상수라고 정의된 함수는 아니다. 개별 find가 항상 한 단계라는 뜻도 아니다.
간선을 하나씩 추가하는 무방향 그래프에서 양끝 대표가 같으면 이미 연결된 경로가 있으므로 그 간선은 사이클을 만든다. 크루스칼 최소 신장 트리가 이 성질을 활용한다. 네트워크의 점진적 연결성 확인에도 쓰인다.
기본 분리 집합은 합치기는 잘하지만 이미 합친 집합에서 원소나 간선을 지워 분리하는 작업을 쉽게 지원하지 않는다. 대표가 어떤 원소인지도 삽입·결합 순서에 따라 달라지며 의미 있는 이름이 아닐 수 있다. 그룹 크기 같은 메타데이터는 union 과정에서 별도로 유지해야 한다.
union이 이미 같은 그룹을 받으면 크기를 다시 더하면 안 된다. 대표 동등성 확인은 사이클 검사뿐 아니라 집합 메타데이터의 정확성을 지키는 조건이다.