분할 상환 분석: 한 번의 비싼 작업이 전체를 느리게 만들까
배열에 원소를 추가하는 기능을 생각해 보자. 보통은 빈칸에 값을 쓰면 끝나지만 저장 공간이 가득 차면 더 큰 배열을 할당하고 기존 원소를 모두 옮긴다. 어떤 추가는 O(1), 어떤 추가는 O(n)이다. 이런 자료구조를 매번 느리다고 평가하는 대신 연속된 연산 전체의 비용을 분석하는 방법이 분할 상환 분석이다.
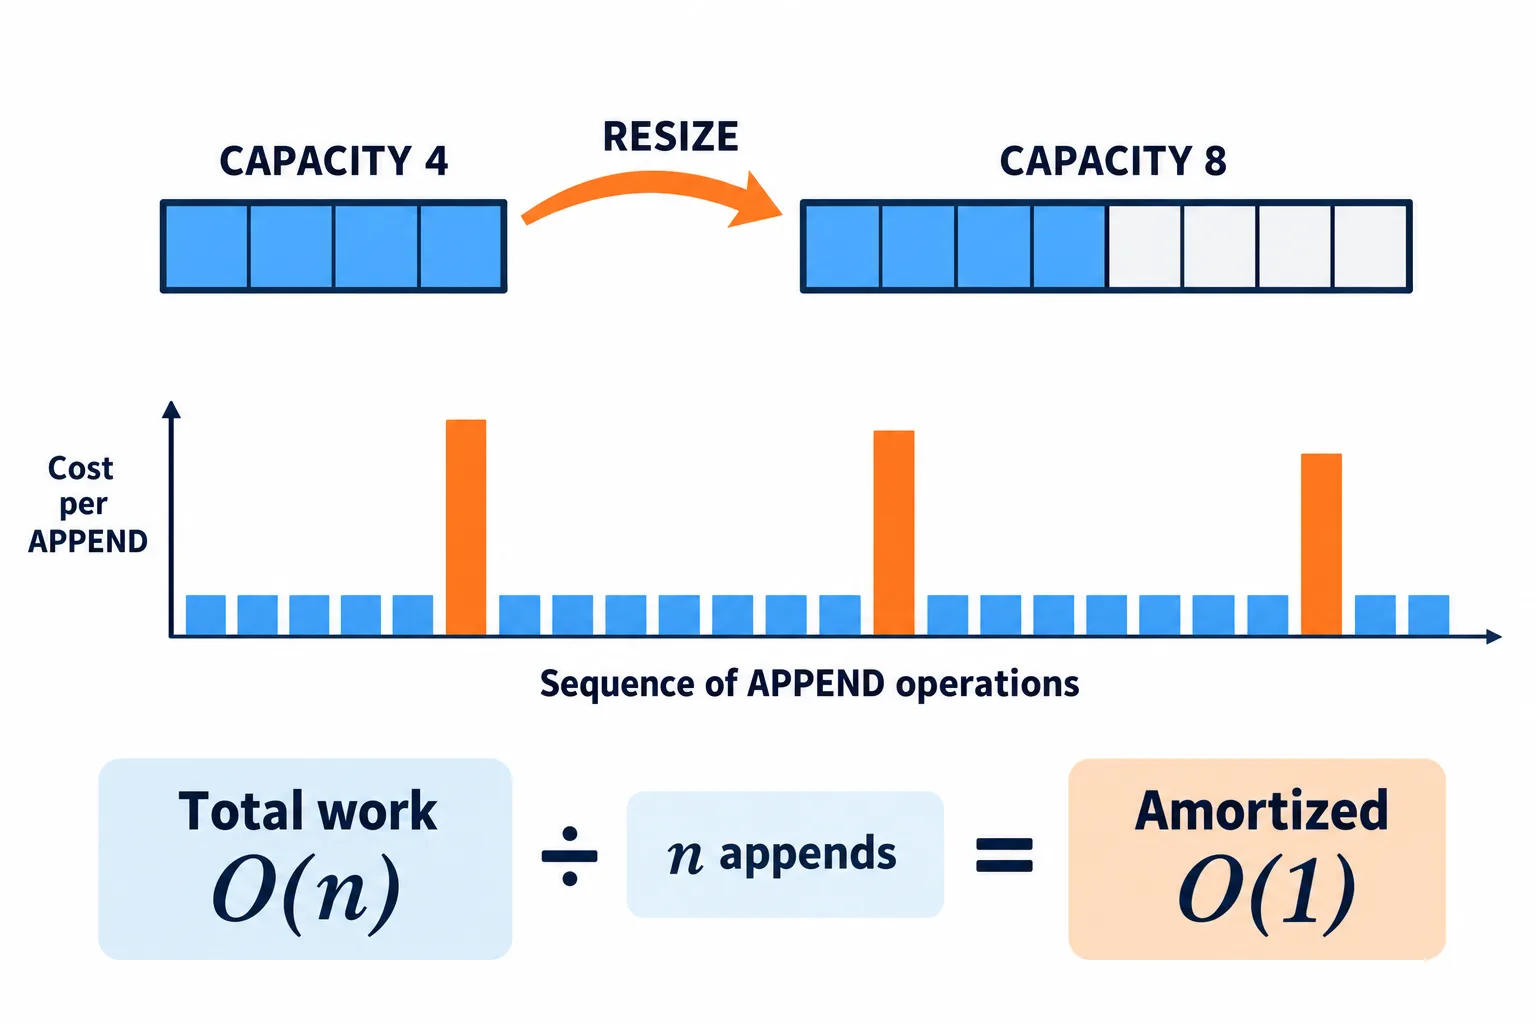
개별 확장 비용은 클 수 있어도 전체 연산 비용을 합해 나누면 분할 상환 비용을 구할 수 있다. 막대는 비용 변화의 개념도다.
확률 없이 평균 비용을 설명하기
분할 상환 비용은 특정 입력이 나올 확률을 평균낸 값이 아니다. 허용되는 연산열 전체에 대해 총비용의 상한을 구한 뒤 연산 수로 나눈다. 따라서 특정 분포나 운 좋은 입력에 의존하지 않는 보장이 가능하다. 다만 개별 연산의 지연시간까지 작게 만드는 보장은 아니다.
용량이 1, 2, 4, 8처럼 두 배로 늘어나는 동적 배열을 보자. n번 추가하는 동안 복사한 원소 수는 1+2+4+…처럼 증가한다. 마지막 복사량이 n보다 작으므로 이 합은 2n보다 작다. 새 원소를 쓰는 n번까지 더하면 총 작업량은 O(n), 추가 한 번의 분할 상환 비용은 O(1)이다.
예를 들어 빈 배열에 아홉 개를 넣으면 용량 부족 시 1개, 2개, 4개, 8개를 복사한다. 아홉 번째 추가는 비싸지만 그 앞의 여러 추가는 싸다. 비싼 사건 사이에 충분히 많은 싼 사건이 있다는 구조가 분석의 핵심이다.
비용을 모으는 세 가지 관점
집계 방법은 총비용을 직접 합산한다. 회계 방법은 싼 연산에 실제 비용보다 조금 더 큰 비용을 부과하고, 남는 몫을 미래의 복사에 사용할 적립금으로 생각한다. 적립금이 음수가 되지 않도록 설계하면 부과한 비용의 합이 실제 비용을 덮는다.
잠재함수 방법은 자료구조 상태에 저장된 부담을 수치 Φ로 표현한다. 실제 비용에 잠재량의 증가분을 더한 값을 분할 상환 비용으로 놓는다. 연속된 연산을 합치면 중간 잠재량들이 상쇄되고 처음과 끝의 차이만 남는다. 이 망원 합이 복잡한 연산열을 간결하게 다루게 한다.
모든 확장 정책이 같은 결과를 주지는 않는다. 용량을 매번 하나씩 늘리면 1+2+…+(n-1)개를 복사하여 총 O(n²)이 된다. 늘리기와 줄이기의 기준을 너무 가까이 두면 삽입·삭제가 반복될 때 계속 재할당할 수 있다.
분할 상환 분석은 자료구조 API의 장기 비용을 판단하는 데 유용하다. 실시간 시스템처럼 한 번의 지연이 문제라면 확장을 조금씩 나누거나 용량을 미리 확보하는 별도 설계가 필요하다. 총비용과 최악의 순간 비용은 함께 확인해야 한다.
복사 횟수를 직접 세어 보기
다음 모형은 새 원소를 쓰는 비용과 기존 원소를 복사하는 비용만 센다. 메모리 할당과 실제 원소 복사의 세부 비용은 생략했다.
def append_work(number_of_elements):
    length, capacity, total_work = 0, 1, 0
    for _ in range(number_of_elements):
        if length == capacity:
            total_work += length
            capacity *= 2
        total_work += 1
        length += 1
    return total_work
n=8이면 쓰기 8번과 복사 1+2+4번으로 15, n=9이면 추가 복사 8번까지 포함해 24다. 한 순간 비용은 급증하지만 전체 작업량은 여전히 n의 상수배로 제한된다.