샤딩: 데이터를 나눌 때 조회와 변경도 함께 나뉜다
샤딩은 전체 데이터를 여러 저장 노드에 분할하여 각 노드가 일부만 담당하게 하는 방식이다. 한 서버의 저장 공간과 처리량 한계를 넘기 위해 사용한다. 같은 데이터를 여러 곳에 두는 복제와 다른 목적이며, 각 샤드를 다시 복제하는 조합도 가능하다.
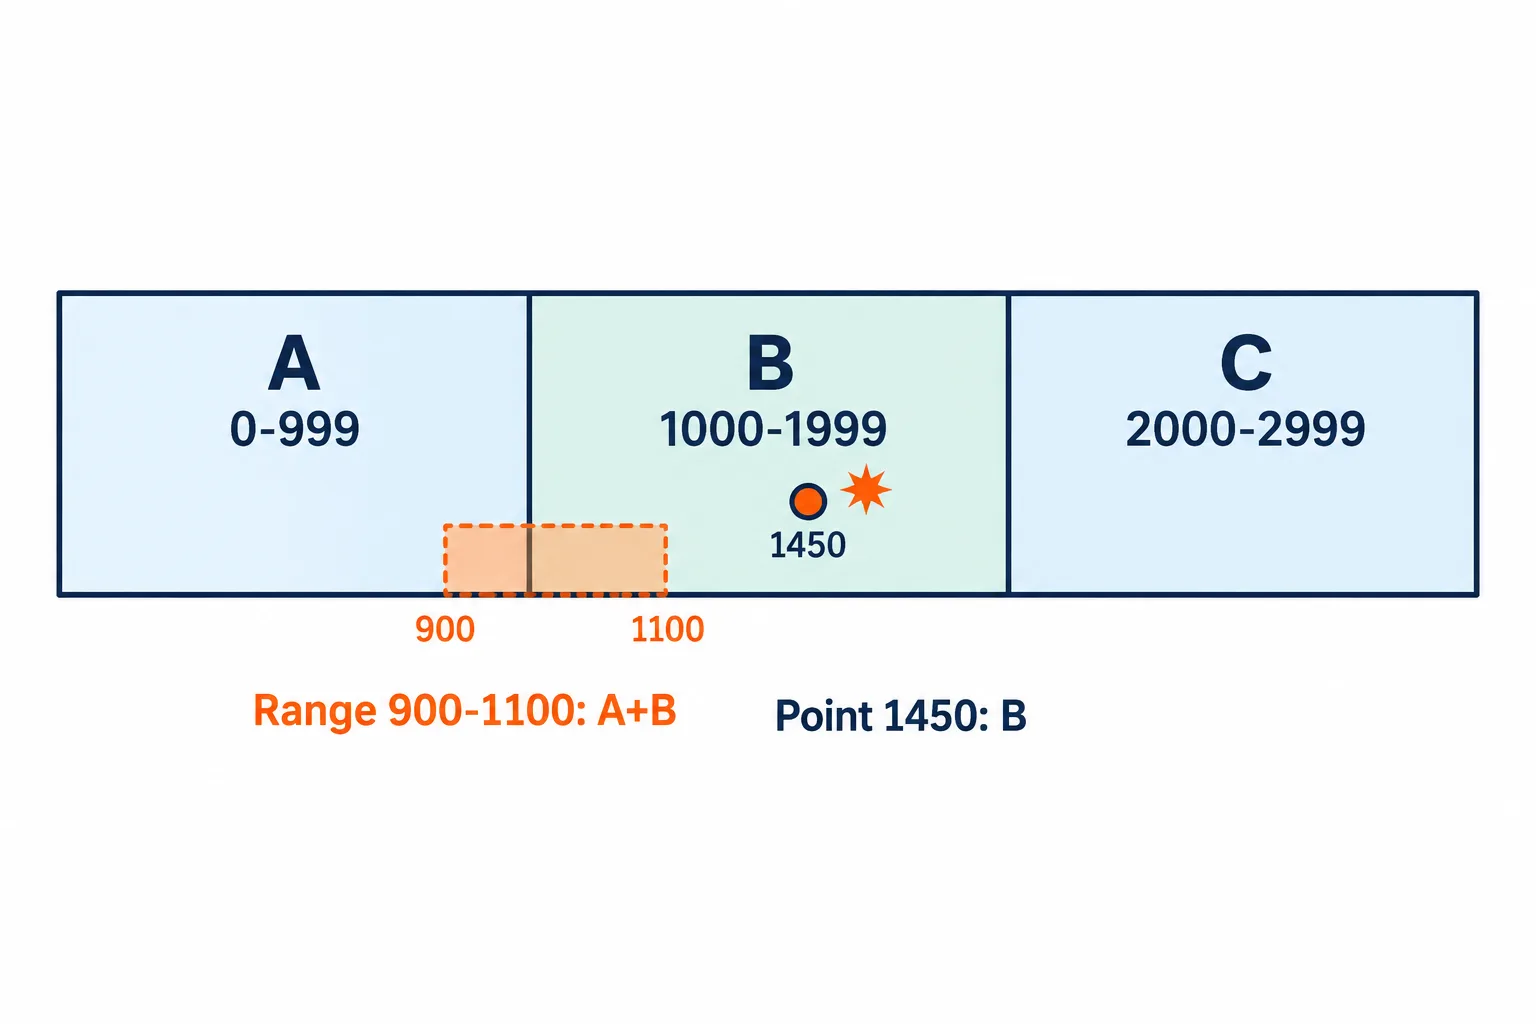
샤드 키는 데이터 배치뿐 아니라 요청의 통신 범위와 핫스팟을 결정한다.
샤드 키가 요청의 목적지를 정한다
사용자 ID를 샤드 키로 두면 한 사용자의 관련 데이터를 같은 곳에 모을 수 있다. 해시 분할은 키의 해시로 담당 샤드를 고르고, 범위 분할은 키 구간별로 나눈다. 해시는 균등 분산에 유리하고 범위는 구간 검색에 자연스럽지만 실제 부하와 데이터 분포를 따져야 한다.
Range partition example:
    shard A: user_id 0 through 999
    shard B: user_id 1000 through 1999
    shard C: user_id 2000 through 2999

Point lookup user_id 1450 -> shard B
Range lookup 900 through 1100 -> shards A and B
샤드 키를 아는 단일 사용자 조회는 담당 노드만 방문한다. 전체 사용자의 최근 주문을 시간순으로 모으는 질의는 여러 샤드에서 결과를 가져와 합쳐야 할 수 있다. 같은 데이터라도 질의 패턴에 따라 분할의 이득과 비용이 달라진다.
데이터 개수와 부하는 같은 것이 아니다
키 개수가 균등해도 인기 사용자 하나에 요청이 집중되면 그 샤드가 핫스팟이 된다. 범위 키가 시간에 따라 증가하면 새 데이터가 마지막 샤드에 몰릴 수도 있다. 더 많은 노드를 추가해도 특정 키의 요청을 하나의 샤드가 독점하면 해결되지 않는다.
hash(key) mod N은 단순하지만 N이 바뀌면 많은 키의 담당 위치가 달라진다. 가상 샤드, 일관된 해싱, 디렉터리 기반 매핑으로 이동량과 배치 유연성을 관리할 수 있다. 어떤 방법이든 실제 데이터를 옮기고 요청을 새 위치로 보내는 절차가 필요하다.
재분배 중에는 이전 위치와 새 위치가 공존한다. 복사 중 쓰기를 어떻게 반영할지, 언제 소유권을 바꿀지, 늦게 온 요청을 어떻게 전달할지 정하지 않으면 누락이나 중복이 생긴다. 샤드 메타데이터 자체의 가용성과 일관성도 중요하다.
샤드 간 이체나 전역 유일성 제약은 단일 노드보다 복잡하다. 여러 곳을 함께 변경하는 트랜잭션, 전역 ID 발급, 조회 결과 병합에 추가 통신과 조정이 필요하다. 모든 작업이 선형으로 빨라지는 구조는 아니다.
샤딩 설계는 데이터량, 키 분포, 읽기·쓰기 패턴, 이동 비용을 함께 보고 결정한다. 용량만 나누는 문제로 보면 운영 중의 핫스팟과 변경 일관성을 놓친다. 단일 노드 설계로 충분한 규모인지 먼저 판단하고, 분할 뒤 자주 실행될 요청이 어디를 방문하는지 구체적으로 추적하는 것이 좋다.
샤드 키를 바꾸는 작업은 단순한 필드 수정이 아닐 수 있다. 데이터의 소유 샤드도 이동해야 하므로 이전 위치의 삭제와 새 위치의 생성이 함께 조정되어야 한다. 키가 자주 바뀌는 데이터는 이런 이동 비용을 사전에 계산하는 것이 좋다.