스레드가 공유하는 것과 따로 가져야 하는 것
영상 편집 프로그램이 파일을 읽는 동안 화면 입력에 반응하고 미리보기를 계산한다면, 하나의 프로세스 안에 여러 실행 흐름을 둘 수 있다. 스레드는 이런 실행 흐름을 표현하는 단위다. 같은 프로세스의 스레드들은 보통 코드와 힙, 열린 파일 같은 자원을 공유하지만, 지금 어느 함수를 실행하고 있는지까지 모두 같지는 않다.
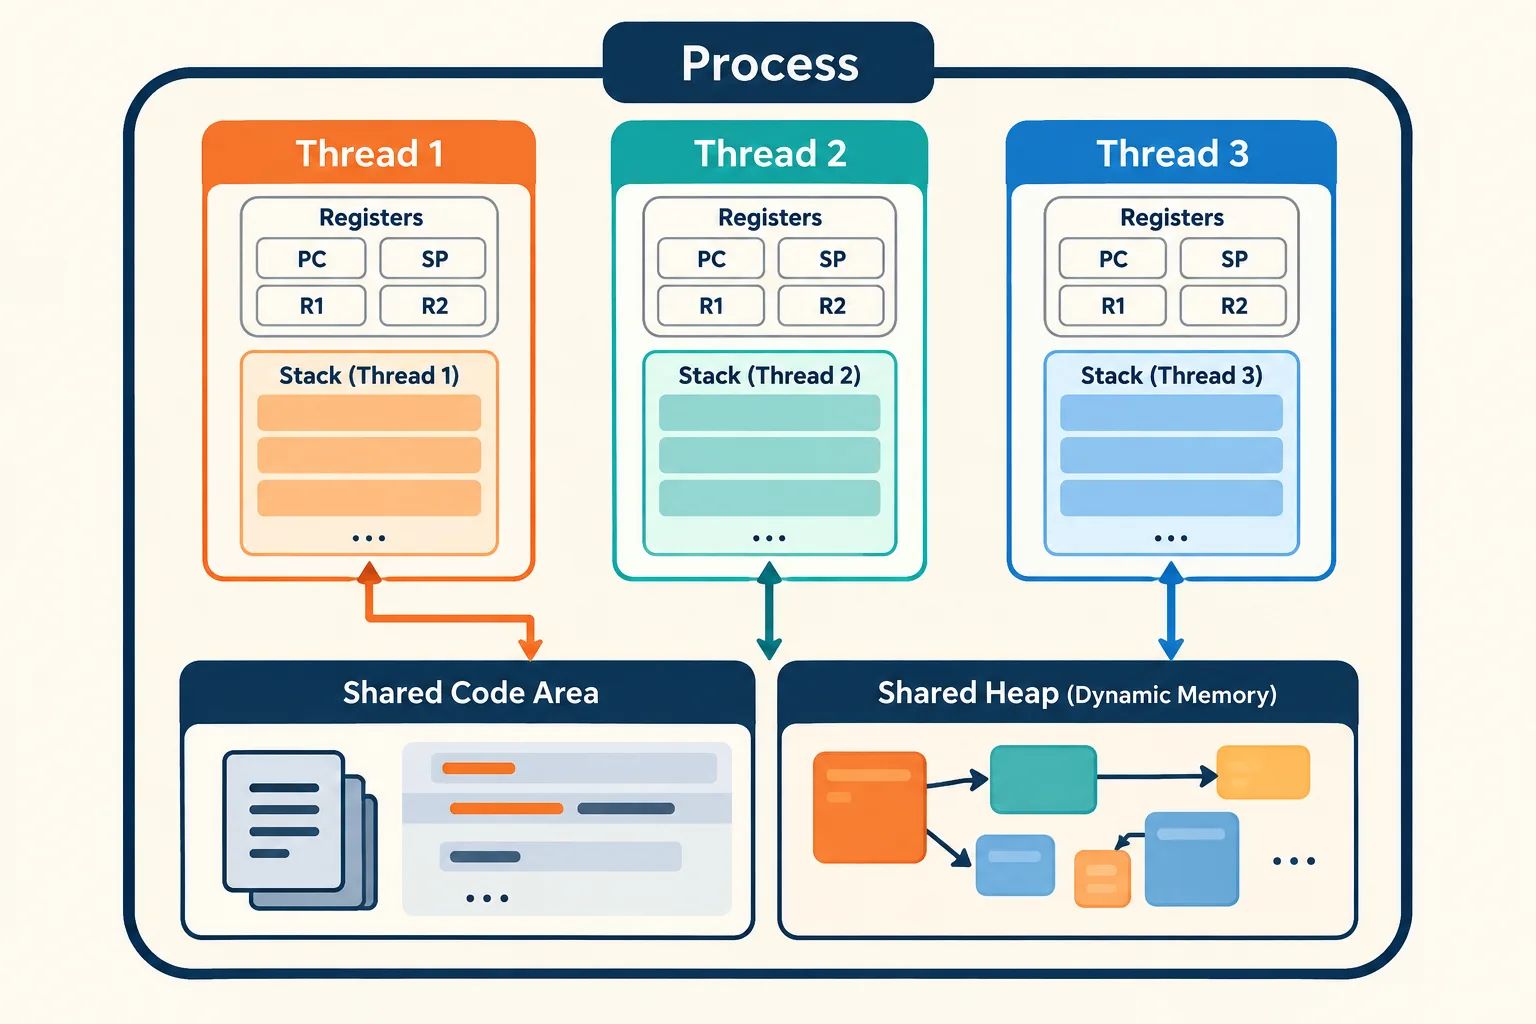
공유 주소 공간과 독립적인 실행 문맥이 스레드의 핵심이다.
같은 공간에서 다른 일을 한다
각 스레드에는 자신의 프로그램 카운터, 레지스터 문맥, 호출 스택이 필요하다. 한 스레드가 파일 읽기 함수 안에 있고 다른 스레드는 화면 그리기 함수 안에 있을 수 있기 때문이다. 호출 스택에는 각 실행 흐름의 지역 변수와 복귀 위치 등이 담긴다. OSTEP의 스레드 설명은 공유 주소 공간과 스레드별 스택을 구분해 보여 준다.
스택이 스레드마다 있다는 말이 다른 스레드는 그 메모리에 절대로 접근할 수 없다는 뜻은 아니다. 같은 주소 공간에 있는 포인터를 전달하면 스택에 있는 객체도 다른 스레드가 접근할 수 있다. 객체의 수명이 끝난 뒤 접근하면 별도의 문제가 된다. 스레드 로컬 저장소 역시 구현 방식은 다르지만, 논리적으로 스레드마다 별도 값을 주려는 장치다.
동시성과 병렬성의 차이
코어 하나에서도 여러 스레드를 번갈아 실행하면 동시성을 제공할 수 있다. 실행 시간이 겹쳐 있는 작업을 진행시키는 것이다. 실제로 여러 코어가 같은 순간 명령을 수행하면 병렬성도 얻는다. 스레드가 네 개라는 사실만으로 네 작업이 언제나 동시에 CPU를 쓰는 것은 아니다. 실행 가능한 코어 수, 운영체제 스케줄링, 언어 실행기의 제약이 모두 영향을 준다.
예를 들어 큰 이미지를 서로 겹치지 않는 네 구역으로 나누고 각 스레드가 한 구역을 처리하면 계산을 병렬화하기 쉽다. 그러나 모든 픽셀 처리 때마다 같은 통계 값을 잠금으로 갱신하면 그 부분에서 줄을 서게 된다. 스레드를 늘린 뒤 속도가 줄어드는 이유는 계산량 부족뿐 아니라 잠금 경쟁, 캐시 통신, 메모리 대역폭 포화일 수도 있다.
공유가 쉬운 만큼 합의가 필요하다
공유 변수에 대한 count += 1은 소스 코드에서 한 줄이어도 읽기·계산·쓰기의 여러 단계가 될 수 있다. 두 스레드가 같은 값을 읽고 각각 증가한 값을 쓰면 갱신 하나가 사라진다. 해결책은 상황에 따라 뮤텍스, 원자적 연산, 메시지 전달, 작업별 결과를 마지막에 합치는 방법이다. 어떤 자료가 공유되는지 먼저 밝히는 일이 기법 선택보다 앞선다.
스레드 종료와 프로세스 종료도 구분해야 한다. 특정 스레드가 일을 마쳐도 다른 스레드는 계속 실행할 수 있다. 하지만 주소 공간을 공유하므로 심각한 메모리 오류가 프로세스 전체를 무너뜨릴 가능성이 있다. 스레드 수를 많이 만들면 스택 공간과 관리 비용도 커지고, 실행 가능한 작업이 많아질수록 문맥 교환이 증가한다.
실무에서는 작업마다 스레드를 무한히 만드는 대신 스레드 풀을 두고 작은 작업을 배분하는 경우가 많다. 계산 중심 작업은 코어와 메모리 자원에 맞추고, 대기가 많은 작업은 대기 방식까지 고려한다. 스레드는 속도를 자동으로 올려 주는 기능이라기보다, 하나의 자원을 여러 실행 흐름이 어떻게 나누고 협력할지 설계하게 만드는 개념이다.