스택: 마지막에 넣은 것을 먼저 꺼내는 이유
스택은 가장 최근에 추가한 원소부터 꺼내는 후입선출 자료형이다. LIFO라는 규칙이 표현하는 것은 저장 모양이 아니라 허용되는 관찰 동작이다. 배열로 만들 수도 있고 연결 리스트로 만들 수도 있다.
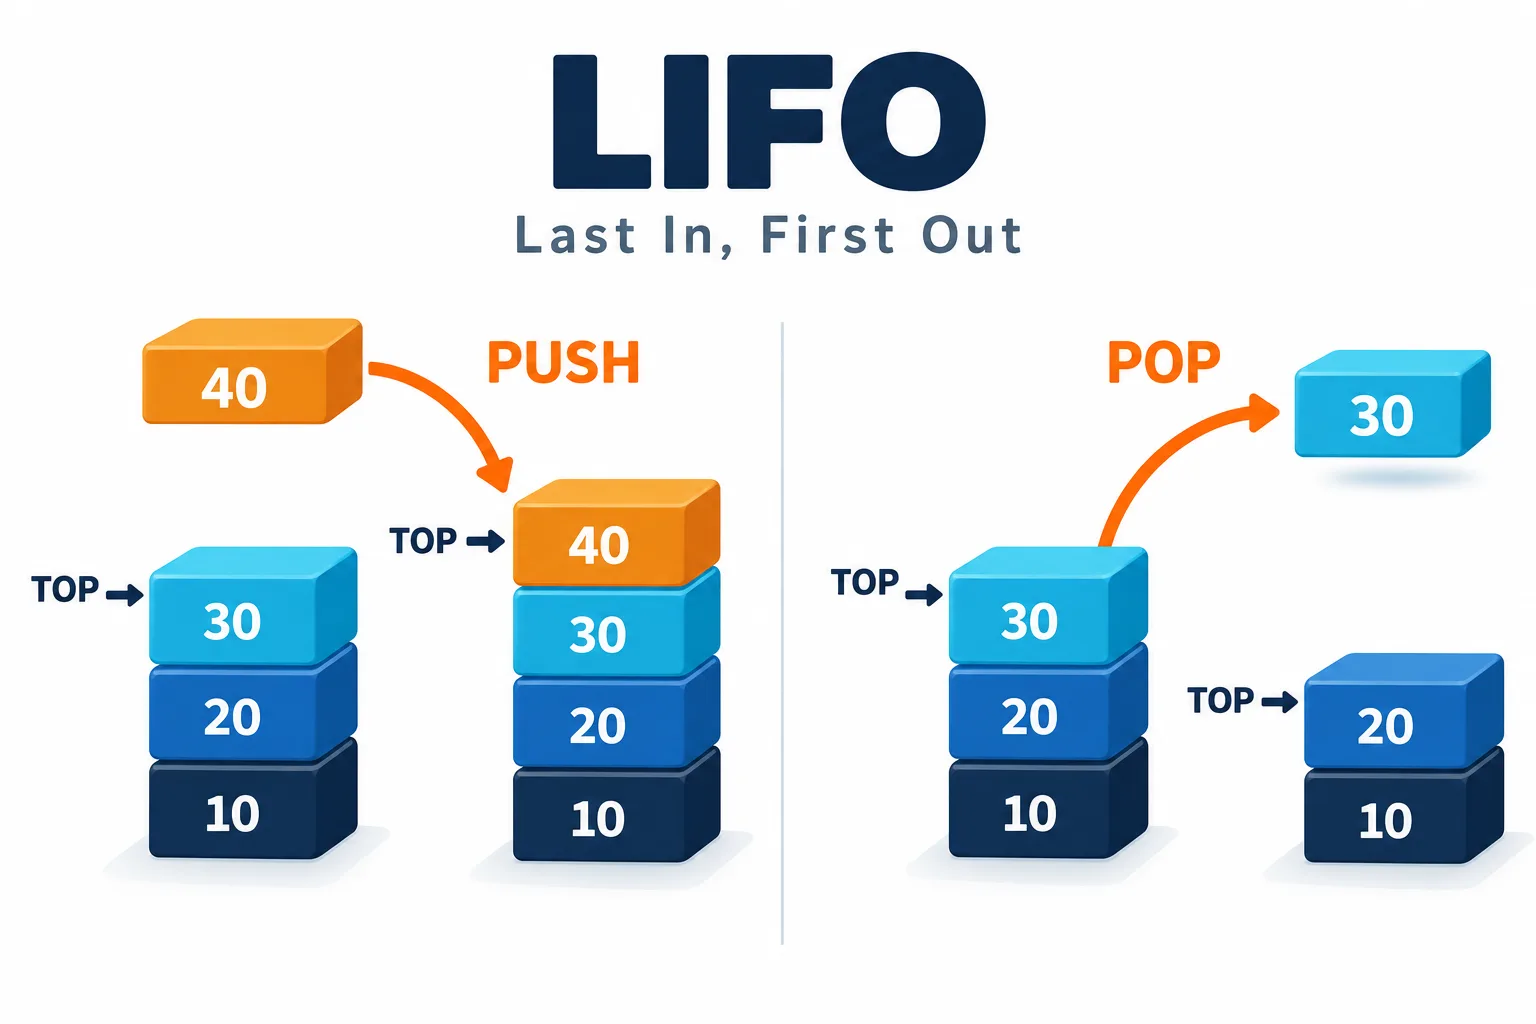
두 그림은 같은 초기 스택에서 각각 수행한 별도의 연산이다. 접근하는 위치는 맨 위다.
위쪽 한 곳에서 바뀌는 상태
push는 원소를 추가하고, pop은 가장 위 원소를 제거하여 반환하며, peek는 제거하지 않고 확인한다. 빈 스택에서 pop이나 peek를 요청했을 때 예외를 내는지 특별한 값을 반환하는지는 API 계약에 속한다. 저장 용량이 고정되어 있다면 가득 찬 상태도 처리해야 한다.
배열 구현에서는 top 또는 길이로 다음 삽입 위치를 관리한다. [A,B,C]에 D를 push하면 [A,B,C,D], pop하면 D가 나오고 [A,B,C]가 남는다. 연결 리스트 구현에서는 head에서 삽입·삭제해 같은 규칙을 얻는다. 자료구조의 외부 동작과 내부 구현은 분리할 수 있다.
괄호 검사로 보는 동작 원리
문자열 '([])'를 읽는다고 하자. '('를 만나면 push하고 '['도 push한다. ']'에서는 가장 최근 열린 '['가 나와야 하며, ')'에서는 '('가 나와야 한다. 닫힘 괄호마다 종류를 검사하고 마지막에 스택이 비었는지 확인하면 중첩 구조가 올바른지 판별할 수 있다.
'([)]'에서는 ')'를 만났을 때 top이 '['이므로 바로 실패한다. 열림·닫힘 개수만 세면 이 오류를 발견하지 못한다. 가장 최근에 아직 끝나지 않은 작업부터 완료한다는 규칙이 중첩 문제에 맞기 때문에 스택이 필요하다.
길이 n 문자열의 각 문자는 한 번 push되거나 pop되므로 시간은 O(n)이다. 모든 문자가 열림 괄호일 수 있으므로 추가 공간은 O(n)이다. 최대 중첩 깊이가 제한되어 있다면 실제 필요한 공간은 그 깊이에 따른다.
동적 배열 스택은 대부분 O(1)로 동작하지만 확장 시 복사가 발생하여 push의 분할 상환 비용이 O(1)이다. 연결 기반 스택은 참조 갱신은 일정하지만 할당 비용과 메모리 오버헤드가 따른다. 고정 배열은 공간이 정해진 대신 확장 비용이 없다.
함수 호출, 되돌리기, 깊이 우선 탐색도 진행 중인 작업을 역순으로 되짚는다는 점에서 스택과 연결된다. 다만 프로그램의 호출 스택에는 반환 주소와 지역 상태가 함께 저장된다. 단순한 값 스택을 이해했다고 모든 실행 환경의 스택 세부 규칙까지 같다고 가정해서는 안 된다.
괄호 검사를 구현하면
def balanced(text):
    opening_for = {')': '(', ']': '[', '}': '{'}
    pending = []
    for character in text:
        if character in '([{':
            pending.append(character)
        elif character in opening_for:
            if not pending or pending.pop() != opening_for[character]:
                return False
    return not pending
이 예는 괄호 외 문자를 무시한다. 빈 스택 검사를 먼저 하므로 잘못된 닫힘 괄호에서도 제거 오류가 나지 않는다. 마지막에 비었는지 확인하는 단계는 닫히지 않은 열림 괄호를 검출한다.