어휘 분석: 소스 코드의 문자들이 토큰으로 바뀌는 과정
소스 코드는 처음에는 문자들의 나열이다. 컴파일러나 인터프리터가 sum += 12를 처리하려면 s, u, m을 각각 계산 명령으로 보아서는 안 된다. 먼저 sum을 식별자, +=를 연산자, 12를 숫자 리터럴로 묶어야 한다. 어휘 분석은 이런 의미 있는 최소 단위인 토큰을 찾아내는 과정이다. 이를 수행하는 구성 요소를 렉서 또는 스캐너라고 부른다.
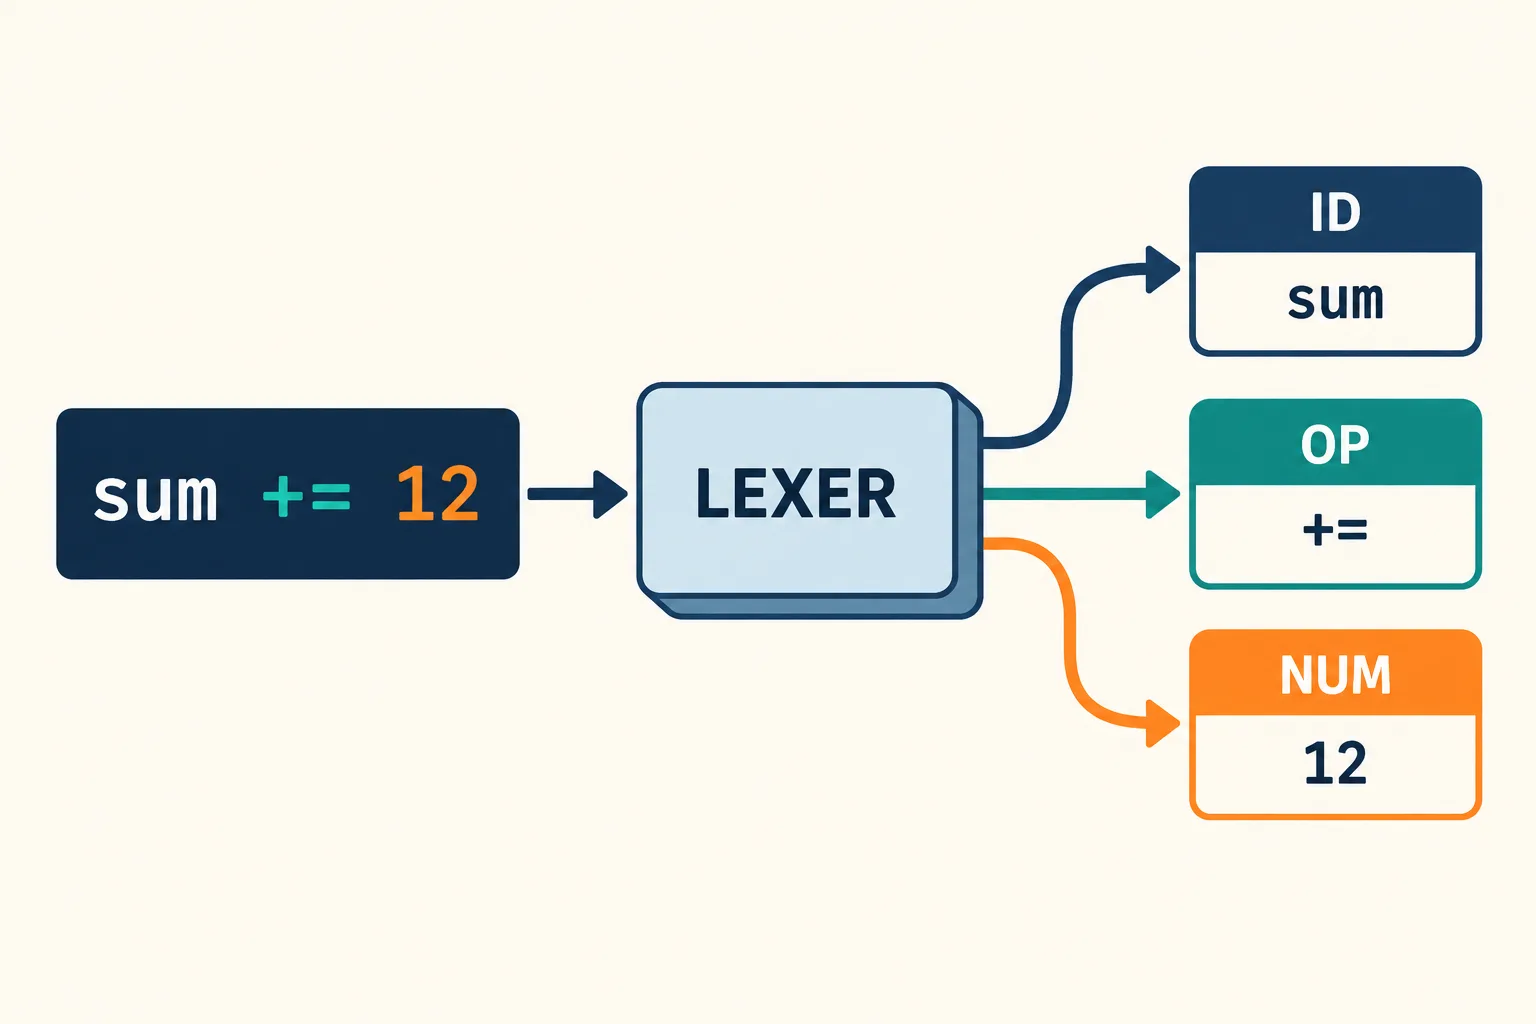
어휘 분석은 문자 나열에서 언어 규칙에 맞는 토큰을 찾아낸다.
토큰의 종류와 실제 표기는 다르다
토큰은 흔히 종류와 값, 위치 정보를 함께 가진다. sum과 count는 표기가 달라도 둘 다 식별자 종류에 속한다. 12는 숫자 토큰이면서 원래 문자열이나 변환된 숫자 값을 담을 수 있다. 줄과 열, 문자 범위를 기록하면 뒤에서 오류가 발견됐을 때 소스의 정확한 위치를 표시할 수 있다. 토큰 자체를 문자열 하나로만 생각하면 이런 정보를 놓친다.
공백은 토큰을 구분하는 역할을 하지만 언제나 버려지는 것은 아니다. 문자열 안의 공백은 값의 일부이고, Python에서는 들여쓰기 변화가 INDENT와 DEDENT 토큰으로 표현된다. Python 어휘 분석 문서는 물리적 줄, 논리적 줄, 들여쓰기와 토큰 사이의 규칙을 구분한다. 언어에 따라 주석을 보존하는 도구도 있으므로 모든 공백과 주석을 무조건 삭제하는 설명은 부정확하다.
가장 길게 읽어야 하는 순간
>=를 읽을 때 >를 먼저 내보내면 이어지는 =의 의미가 달라진다. 많은 언어의 렉서는 가능한 토큰 중 가장 긴 것을 선택하는 원칙을 사용한다. 이를 최대 일치라고 한다. ifx가 허용되는 식별자라면 보통 키워드 if와 식별자 x로 쪼개지 않고 하나의 식별자로 읽는다. 키워드인지 여부는 완성된 표기를 확인한 뒤 구분할 수도 있다.
규칙을 구현하는 대표적인 방법은 유한 상태 기계다. 숫자의 첫 문자를 만나면 숫자 상태로 들어가고, 다음 숫자를 읽는 동안 같은 상태를 유지한다. 소수점이나 지수 표기를 허용하려면 전이와 종료 조건을 추가한다. 정규식으로 토큰 규칙을 적고 이를 상태 기계로 변환하는 생성기도 있다. 언어의 원시 문자열이나 중첩 주석처럼 별도 상태 관리가 필요한 부분도 있다.
토큰화가 문장의 뜻까지 결정하지는 않는다
a + * b는 식별자와 연산자로 모두 토큰화될 수 있지만 올바른 표현식은 아니다. 연산자가 어떤 순서로 배치돼야 하는지는 구문 분석 단계에서 판단한다. 반대로 따옴표가 닫히지 않은 문자열이나 허용되지 않는 문자처럼 토큰 자체를 만들 수 없는 오류는 어휘 단계에서 발견할 수 있다. 이 경계는 오류 메시지의 책임을 나누는 데 도움이 된다.
실용적인 렉서는 유니코드 식별자, 줄바꿈 표현, 이스케이프 문자와 파일 인코딩까지 고려한다. 눈에 비슷한 문자가 같은 문자라는 보장은 없고, 소스의 문자 위치와 바이트 위치도 항상 일치하지 않는다. 따라서 편집기와 오류 표시 도구를 연동할 때는 위치 정보가 무엇을 세는지 명확해야 한다. 간단한 영문 예제에서 보이지 않던 문제가 실제 코드에서 나타나는 지점이다.
대체로 입력을 한 번 훑는 렉서는 소스 길이에 비례하는 시간을 목표로 설계할 수 있다. 하지만 과도한 되돌리기나 잘못된 정규식 구현은 비용을 키울 수 있다. 어휘 분석을 이해하면 컴파일러의 첫 단계뿐 아니라 구문 강조, 코드 검색, 설정 파일 읽기에서도 문자열을 자르는 방식과 언어 규칙에 따라 토큰을 만드는 방식의 차이를 분명히 볼 수 있다.