연결 리스트: 포인터로 이어진 원소들의 장점과 비용
연결 리스트는 각 원소를 노드에 저장하고 다음 노드의 위치를 참조로 이어 놓는 자료구조다. 노드들이 메모리에서 붙어 있을 필요는 없다. 배열처럼 주소를 계산해 원하는 인덱스로 뛰어가기보다 연결을 따라 이동한다.
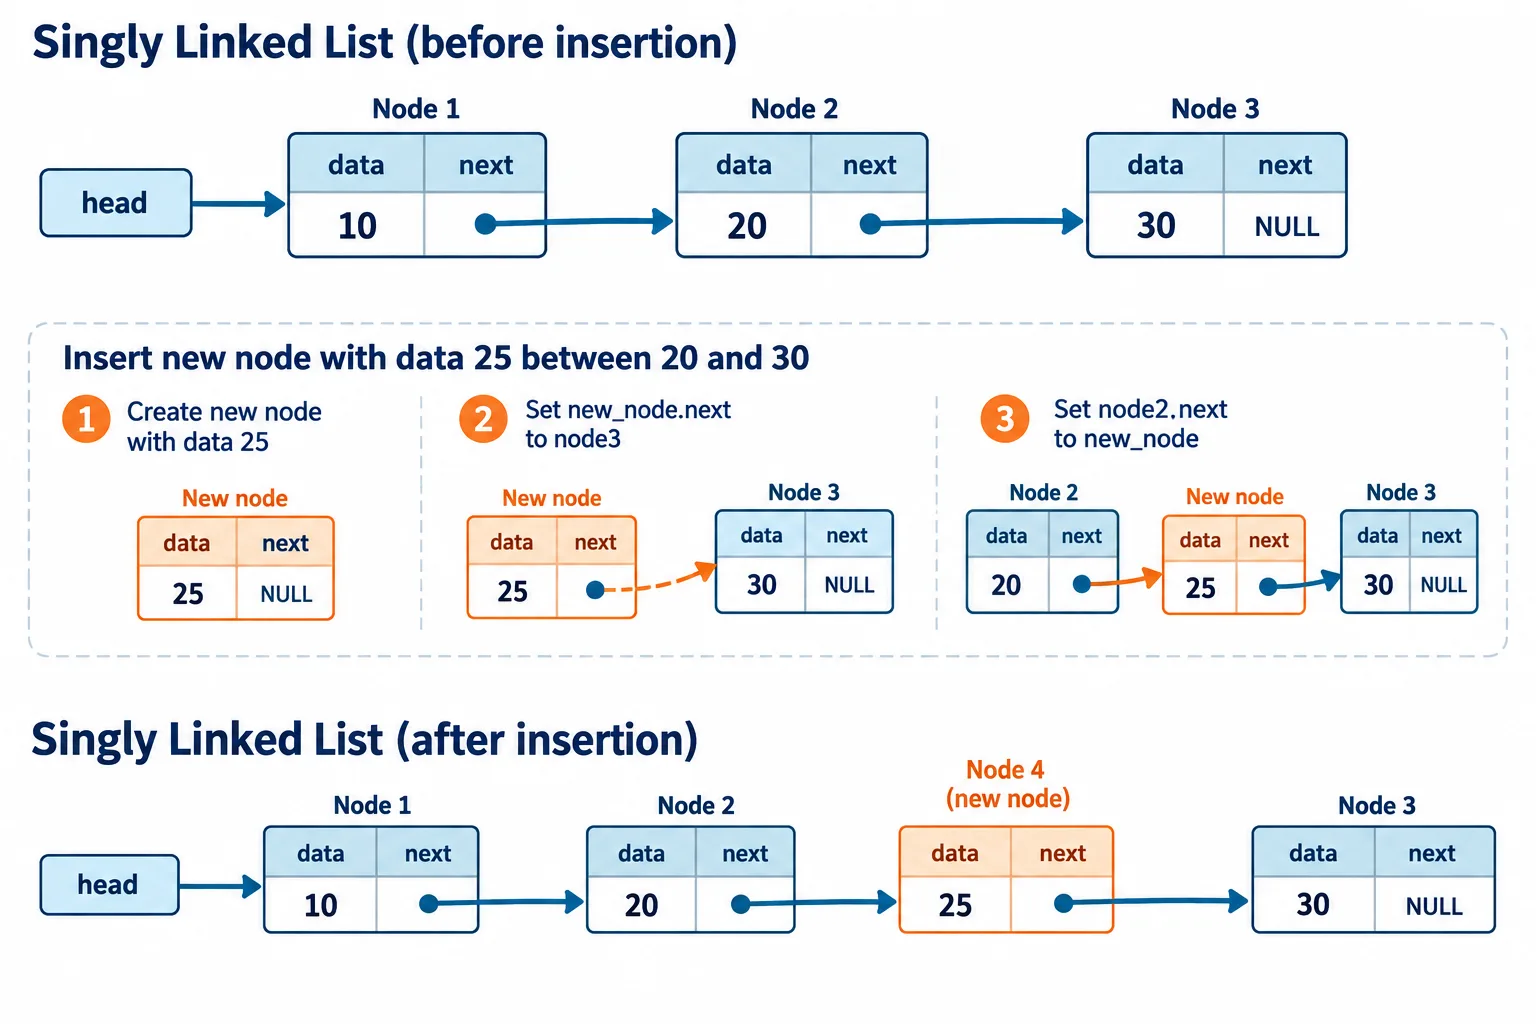
원소를 이동하는 대신 노드 사이의 연결을 바꾸어 삽입한다.
한 노드가 가진 정보
단일 연결 리스트의 노드는 값과 다음 노드 참조를 가진다. head는 첫 노드를 가리키고 마지막 노드의 next는 비어 있다. 이중 연결 리스트는 이전 노드 참조도 저장하여 양방향 이동이 가능하다. 비어 있는 리스트와 첫·마지막 노드에 대한 처리 규칙을 명확히 해야 한다.
A→B→C에서 B 뒤에 X를 넣는다고 하자. 먼저 X.next를 기존 B.next인 C로 놓고, 그다음 B.next를 X로 바꾸면 A→B→X→C가 된다. 순서를 반대로 바꾸고 기존 다음 노드를 저장하지 않았다면 C로 가는 연결을 잃을 수 있다.
이 삽입은 B의 위치를 이미 알고 있다는 조건에서 O(1)이다. “인덱스 500 뒤에 삽입”이라는 요청이라면 먼저 그 노드를 찾는 데 O(n)이 걸린다. 연결 리스트의 삽입이 항상 O(1)이라는 설명은 탐색 비용을 생략한 것이다.
삭제에 필요한 참조
단일 리스트에서 B를 삭제하려면 보통 앞 노드 A의 next를 C로 바꿔야 한다. 삭제 대상 B만 안다고 앞 노드를 즉시 알 수 있는 것은 아니다. 이중 리스트는 B.prev로 A를 찾을 수 있지만, 두 방향의 연결을 모두 올바르게 갱신해야 한다.
첫 노드 삭제, 마지막 노드 삭제, 원소가 하나뿐인 경우에는 head와 tail도 달라질 수 있다. 더미 노드나 원형 센티널을 사용하면 분기를 줄일 수 있지만 그 노드가 실제 데이터인지 구분해야 한다. 개수가 저장되어 있다면 삽입·삭제마다 함께 갱신한다.
인덱스 접근은 O(n), 알려진 위치의 삽입·삭제는 조건에 따라 O(1)이다. 노드마다 참조와 할당 관리 정보가 필요하고, 메모리 위치가 흩어지면 캐시 효율이 낮아질 수 있다. 포인터를 바꾸는 이론적 작업 수가 적어도 실제 속도가 배열보다 빠르다고 단정할 수 없다.
연결 리스트는 안정된 노드 위치, 잦은 국소 삽입·삭제, 양끝 변경 같은 요구에 적합하다. 운영체제의 큐나 캐시의 순서 관리에 응용할 수 있지만 동시 접근에서는 연결 갱신을 보호해야 한다. 메모리 해제 시 아직 참조하는 코드가 없는지도 중요하다.
연결 하나를 안전하게 바꾸기
def insert_after(previous_node, value):
    new_node = Node(value)
    old_successor = previous_node.next
    new_node.next = old_successor
    previous_node.next = new_node
    return new_node
이 코드에서 previous_node는 실제 리스트에 속한 유효 노드라고 가정한다. 끝 노드 뒤에 넣으면 old_successor는 비어 있고, tail을 관리하는 리스트라면 tail도 새 노드로 바꿔야 한다. 외부 코드가 아직 old_successor를 가리켜도 그 노드는 그대로 존재한다. 구조 변경과 메모리 수명은 서로 다른 관리 문제라는 점도 함께 드러난다.