우선순위 큐: 가장 급한 작업을 고르는 자료형
우선순위 큐는 원소를 넣은 시간보다 지정된 우선순위에 따라 꺼내는 추상 자료형이다. 최소 우선순위 큐는 가장 작은 키, 최대 우선순위 큐는 가장 큰 키를 먼저 반환한다. 숫자가 작을수록 급한지 큰 쪽이 급한지는 시스템의 계약에 달려 있다.
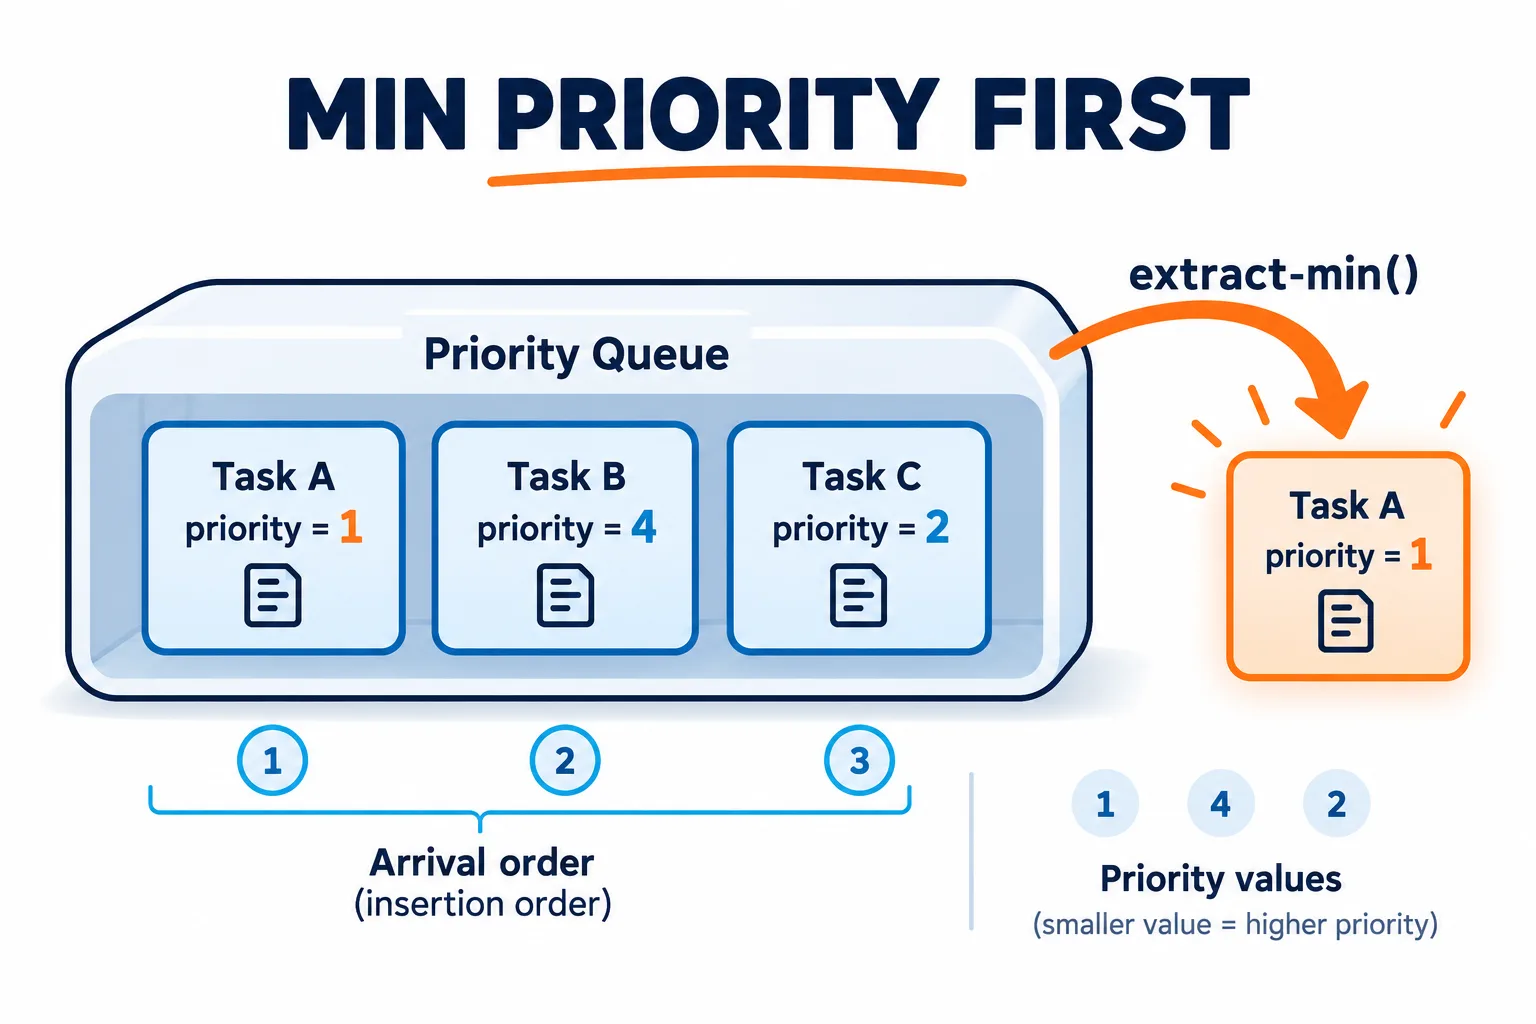
이 예시는 작은 숫자를 높은 우선순위로 해석하는 최소 우선순위 큐다.
규칙과 구현을 분리하기
우선순위 큐는 반드시 힙이어야 하는 것은 아니다. 정렬되지 않은 배열은 삽입이 빠르고 추출에 전체 탐색이 필요하다. 정렬 배열은 추출이 쉽지만 삽입할 위치를 찾고 옮기는 비용이 크다. 이진 힙은 두 작업을 O(log n)으로 균형 있게 제공한다.
응급 작업 A의 우선순위가 3, B가 1, C가 2이면 최소 큐는 B,C,A 순으로 꺼낸다. 먼저 들어온 A를 먼저 처리하는 FIFO와 다른 정책이다. 하지만 B와 C의 우선순위가 같을 때 누가 먼저 나오는지는 기본 정의만으로 정해지지 않는다.
동률에서 도착 순서를 보존하려면 (우선순위, 증가 순번, 작업) 형태로 저장할 수 있다. 아래는 Python의 최소 힙을 사용하는 예로, 순번 덕분에 작업 객체 자체를 비교할 필요도 줄인다.
import heapq
import itertools

waiting_jobs = []
arrival_sequence = itertools.count()

def submit_job(priority, job):
    entry = (priority, next(arrival_sequence), job)
    heapq.heappush(waiting_jobs, entry)

def take_next_job():
    priority, sequence_number, job = heapq.heappop(waiting_jobs)
    return job
빈 큐에서 추출하는 오류와 우선순위 값의 유효성은 별도로 처리해야 한다. 위 예의 순번은 한 실행 흐름을 가정하며, 여러 생산자가 함께 사용할 때는 공유 상태의 안전성을 추가로 설계한다.
우선순위가 바뀌는 경우
대기 시간이 길어지면 우선순위를 높이는 정책이나 최단 경로의 거리를 줄이는 연산이 필요할 수 있다. 일반 힙에서 항목 위치를 모르면 찾는 데 O(n)이 든다. 인덱스 맵을 유지하거나 새 항목을 넣고 오래된 항목을 무시하는 지연 삭제 기법을 쓸 수 있다.
최소 확인은 힙에서 O(1), 추가·추출은 O(log n)이며 메모리는 항목 수에 비례한다. 높은 우선순위 작업만 계속 오면 낮은 작업이 기아 상태에 빠질 수 있다. 자료형의 정렬 규칙이 공정성까지 자동으로 보장하지 않는다.
이벤트 시뮬레이션에서는 가장 이른 시간의 사건을, 경로 탐색에서는 가장 작은 거리 후보를 먼저 꺼낸다. 우선순위 큐를 설계할 때는 비교 기준, 동률 정책, 변경 방식, 취소 방식이 결과의 정확성과 운영 정책을 함께 결정한다.
취소된 작업을 즉시 힙에서 찾기 어렵다면 취소 표시를 따로 두고 추출 시 건너뛸 수 있다. 이 방식은 논리적 대기 수와 실제 힙 항목 수가 달라지므로 메모리 회수와 통계도 별도로 관리해야 한다. 취소 항목은 실제 실행하지 않는다.