원형 버퍼: 배열의 끝을 다시 처음으로 연결하는 방법
원형 버퍼는 고정된 배열을 원처럼 재사용하는 저장 방식이다. 원소가 메모리에서 실제로 원을 이루는 것은 아니다. 배열 끝을 지난 인덱스를 처음으로 되돌려 읽기와 쓰기 위치를 관리한다. 스트리밍 데이터나 생산자·소비자 큐에 자주 쓰인다.
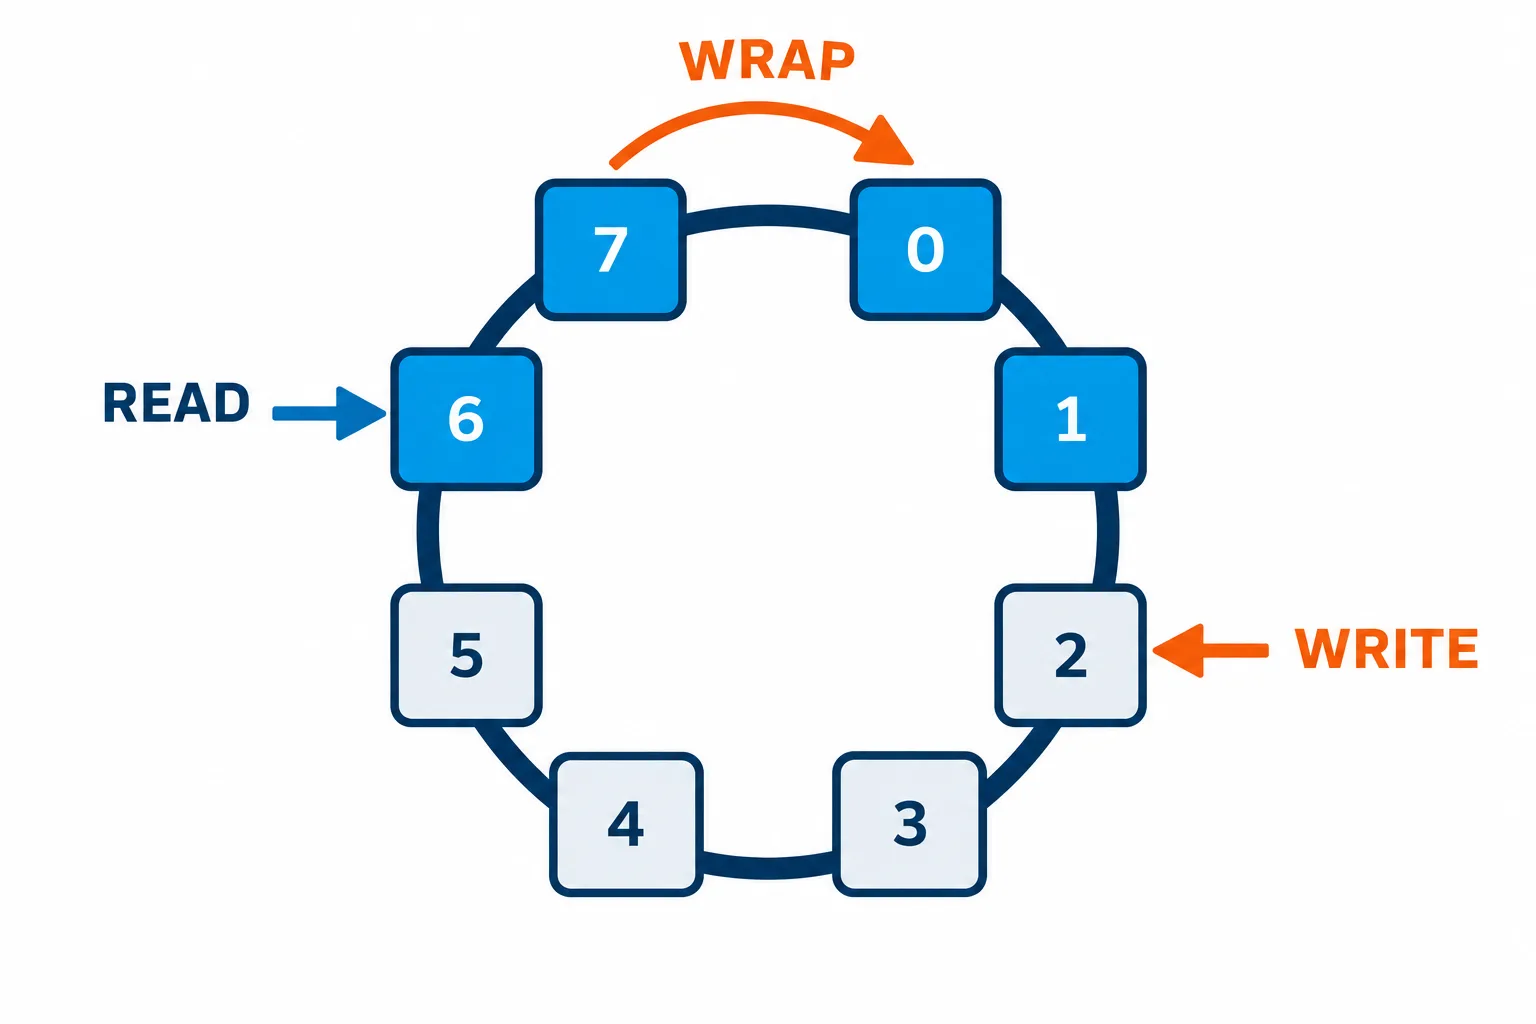
인덱스가 끝에 도달하면 처음으로 돌아가 저장 공간을 순환한다.
두 인덱스의 의미
capacity가 C이고 head가 다음 읽기 위치, tail이 다음 쓰기 위치라고 정하자. 추가 후 tail=(tail+1) mod C, 제거 후 head=(head+1) mod C로 갱신한다. 구현마다 이름의 의미가 반대일 수 있으므로 규칙을 먼저 고정해야 한다.
크기 4 버퍼에서 위치 2와 3에 B, C가 있고 head=2, tail=0이라면 다음 값 D는 위치 0에 들어간다. 물리 배열에서는 데이터가 두 구간에 나뉘지만 논리적 순서는 B, C, D다. 조회와 순회도 이 논리 순서를 따라야 한다.
head와 tail이 같을 때는 비어 있는 상태와 한 바퀴 가득 찬 상태를 구별할 정보가 부족하다. 원소 수를 별도로 저장하거나, 한 칸을 항상 비워두거나, 회전 세대 정보나 full 플래그를 함께 저장한다. 한 칸을 비우는 구현에서 배열 크기 C의 유효 저장량은 C-1이다.
가득 찼을 때 무엇을 할까
버퍼가 가득 차면 새 데이터를 거부하거나, 생산자를 기다리게 하거나, 가장 오래된 데이터를 덮어쓸 수 있다. 최근 센서 기록만 중요하면 덮어쓰기가 적합할 수 있고, 결제 작업처럼 누락이 안 되는 데이터라면 대기나 오류 처리가 필요하다. 이 정책은 단순 구현 선택이 아니라 데이터 의미를 바꾼다.
삽입·삭제는 값 복사와 일정한 인덱스 갱신으로 O(1)이며, 미리 할당한 배열을 재사용하면 운영 중 재할당을 피할 수 있다. 다만 저장할 원소 자체가 크거나 별도 메모리를 관리한다면 그 원소의 생성·복사 비용은 추가된다.
용량이 2의 거듭제곱이면 일부 구현은 나머지 연산 대신 비트 마스크를 사용할 수 있다. 모든 용량에 적용되는 규칙은 아니며, 정확한 코드와 컴파일러 최적화를 살펴야 한다. 성능을 위해 인덱스 계산의 의미를 흐리면 오류가 생기기 쉽다.
여러 스레드가 사용한다고 해서 원형 배열만으로 안전한 큐가 되는 것은 아니다. 생산자가 값을 쓴 뒤 쓰기 위치를 공개하고 소비자가 올바른 순서로 읽도록 동기화와 메모리 순서를 설계해야 한다. 특히 단일 생산자·단일 소비자용 구현을 다중 생산자에 그대로 적용해서는 안 된다.
원소 수를 함께 저장한 모형
enqueue(value):
    if count == capacity:
        report full
    buffer[tail] = value
    tail = (tail + 1) mod capacity
    count = count + 1

dequeue():
    if count == 0:
        report empty
    value = buffer[head]
    head = (head + 1) mod capacity
    count = count - 1
    return value
full과 empty를 보고한 경우 해당 연산은 즉시 종료한다고 가정한다. head와 tail이 같아도 count=0이면 비어 있고 count=capacity면 가득 찼다고 알 수 있다. capacity는 양수여야 모듈러 계산이 정의된다.