유한 오토마타: 제한된 상태로 문자열을 판정하기
유한 오토마타는 입력을 왼쪽에서 오른쪽으로 읽으며 정해진 유한 상태 사이를 이동하는 계산 모델이다. 입력 전체를 저장하지 않고 현재 상태에 필요한 과거 정보만 요약한다. 다 읽은 뒤 현재 상태가 수락 상태인지로 문자열의 포함 여부를 판단한다.
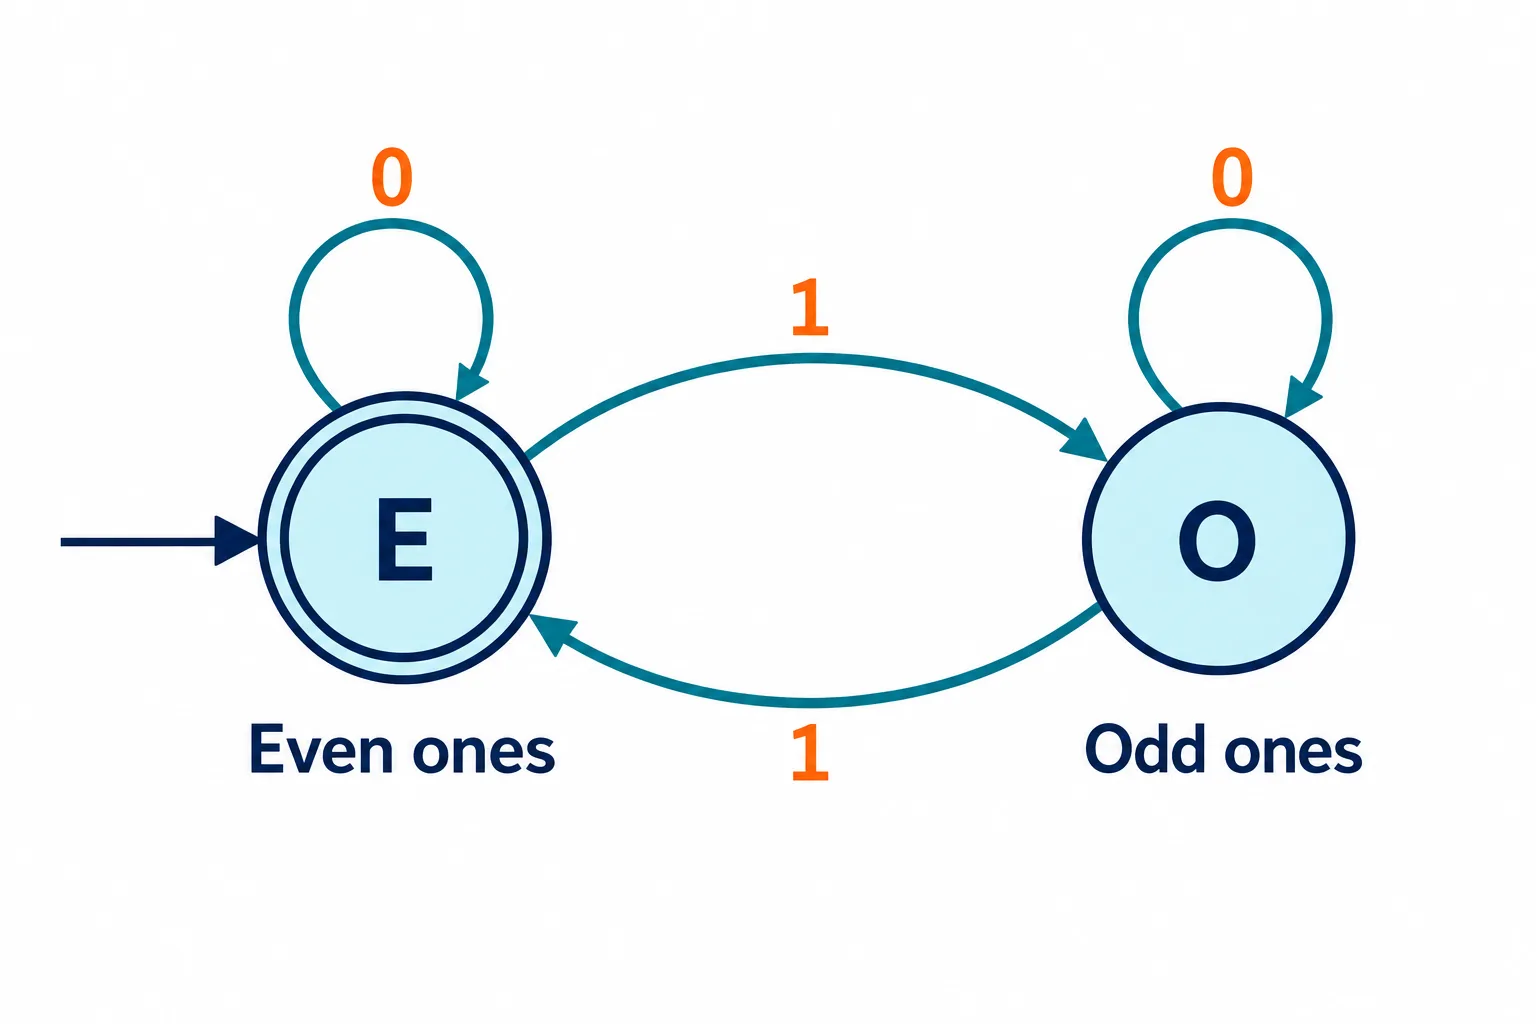
유한 오토마타의 상태는 입력의 전체 내용 대신 판정에 필요한 과거 정보를 요약한다.
다섯 가지 구성 요소
결정적 유한 오토마타, DFA는 상태 집합, 입력 알파벳, 전이 함수, 시작 상태, 수락 상태 집합으로 정의한다. 전이 함수는 현재 상태와 다음 문자에 대해 정확히 한 다음 상태를 정한다. 모든 입력에 대해 규칙이 있어야 하며 불가능한 경로에는 실패 상태를 둘 수 있다.
0과 1로 이루어진 문자열에서 1의 개수가 짝수인지 판단하려면 두 상태면 충분하다. E는 지금까지 짝수, O는 홀수라는 뜻이다. 0을 읽으면 상태가 그대로이고 1을 읽으면 E와 O 사이를 바꾼다. 시작 상태와 수락 상태는 E다.
def even_number_of_ones(text):
    state = "E"
    transition = {
        ("E", "0"): "E", ("E", "1"): "O",
        ("O", "0"): "O", ("O", "1"): "E",
    }
    for character in text:
        if character not in "01":
            raise ValueError("Alphabet is 0 or 1")
        state = transition[(state, character)]
    return state == "E"
1011은 E→O→O→E→O로 진행하여 거절된다. 110은 E→O→E→E라 수락된다. 빈 문자열에는 1이 0개 있어 수락된다. 문자열이 매우 길어도 기억해야 할 정보는 상태 두 개 중 하나뿐이다.
상태가 요약할 수 있는 범위
길이 n 입력을 한 번 읽으므로 시간 O(n), 고정된 오토마타의 실행 상태는 O(1) 공간이다. 오토마타를 저장하는 공간과 입력 길이에 따른 실행 공간은 별도로 센다. 더 복잡한 언어에는 더 많은 상태가 필요할 수 있다.
NFA는 한 상태와 문자에서 여러 다음 상태를 허용하며, 입력을 소비하지 않는 ε 전이도 사용할 수 있다. 하나라도 수락 경로가 있으면 수락한다. 이는 실제 기계가 마법처럼 정답 경로를 즉시 고른다는 뜻이 아니라 가능한 상태 집합을 추적할 수 있는 모델이다.
DFA와 NFA는 같은 정규 언어를 인식하지만 NFA를 DFA로 바꿀 때 상태 수가 크게 늘 수 있다. 모델의 표현 크기와 인식 능력은 다른 문제다.
유한 상태로는 임의 깊이의 중첩 괄호처럼 무한히 다양한 기억을 요구하는 구조를 일반적으로 구별할 수 없다. 반면 프로토콜의 제한된 상태 전이, 토큰 패턴, 입력 형식 검증에는 잘 맞는다. 상태마다 어떤 과거 정보를 요약하는지 설명하면 전이 규칙과 한계를 함께 이해할 수 있다.
수락 상태에서도 다음 입력을 계속 읽을 수 있다. 중간에 수락 상태를 방문했다는 사실만으로 전체 문자열을 수락하지 않는다. 마지막 입력을 처리한 뒤의 상태가 판정 기준이다.