인터넷은 왜 여러 층으로 통신할까: 프로토콜 계층화
브라우저가 웹페이지를 받아오는 일에는 주소 찾기, 데이터 전달, 손실 복구, 신호 전송이 함께 필요하다. 프로토콜 계층화는 이 책임들을 나누고, 각 계층이 아래 계층의 서비스를 이용하면서 위 계층에 일정한 인터페이스를 제공하는 설계 방식이다. 같은 계층끼리 주고받는 규칙인 프로토콜과, 한 컴퓨터 안에서 인접 계층을 사용하는 방법인 인터페이스는 구분해야 한다.
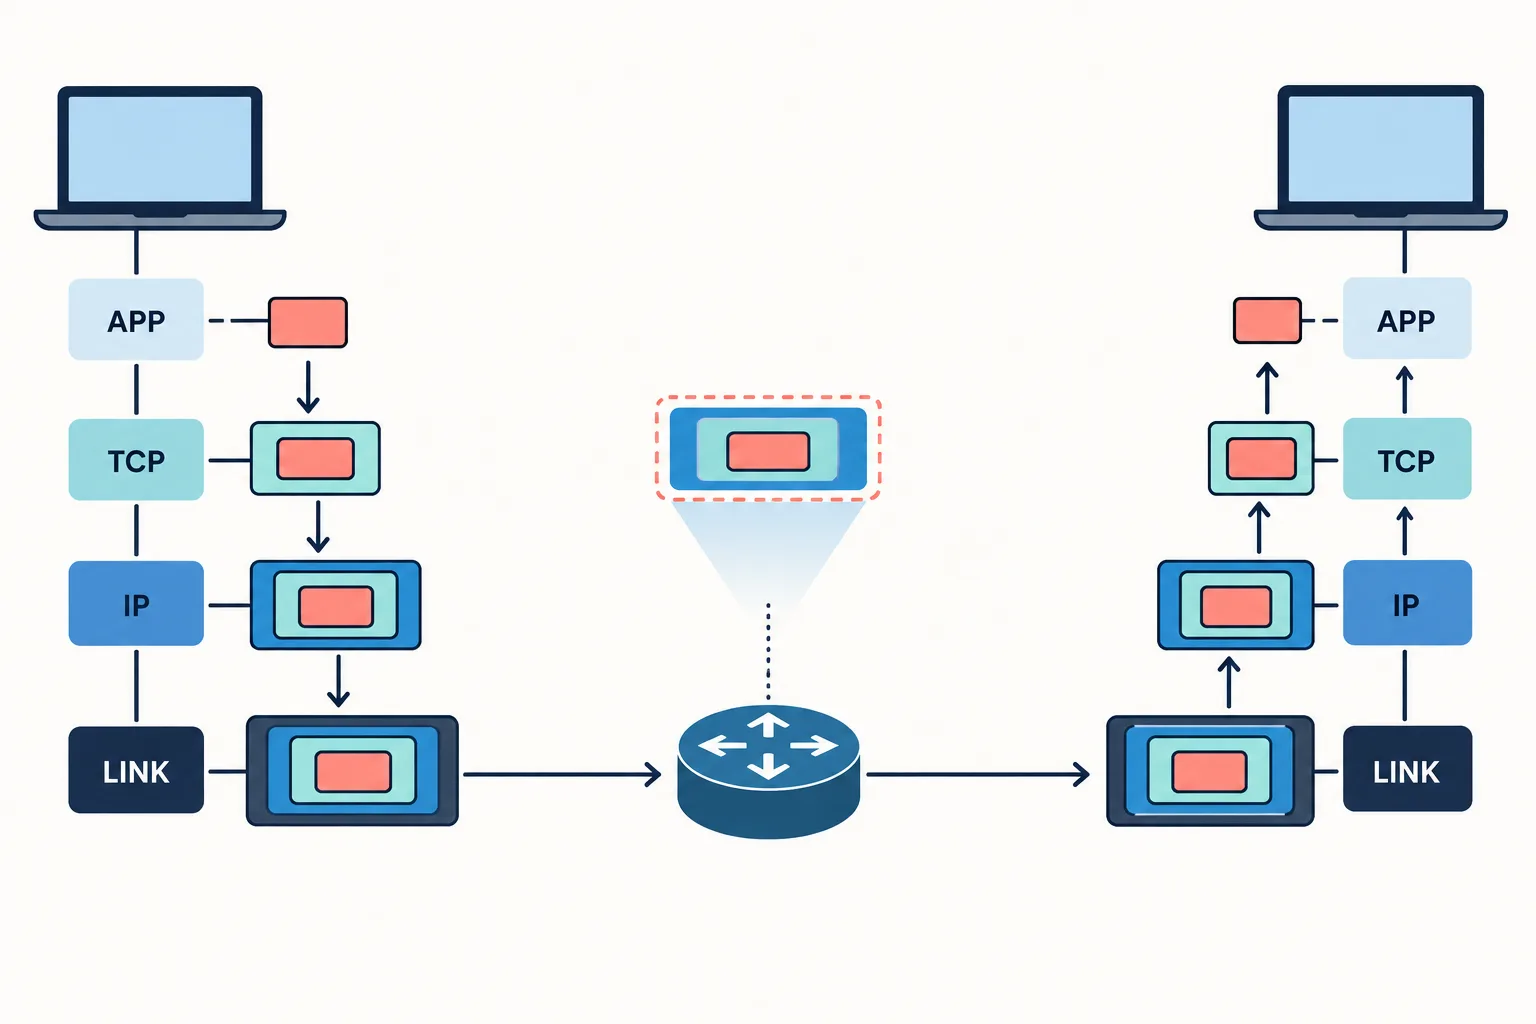
계층마다 다른 책임을 맡지만 응용 데이터는 캡슐화된 채 전달된다.
데이터가 여러 봉투를 입는 과정
HTTP 요청을 TCP로 보낸다고 해 보자. 응용 데이터 앞에는 TCP 헤더가 붙고, 그 결과는 IP 패킷의 내용이 된다. 다시 링크 계층이 프레임 헤더 등을 붙여 실제 연결로 전달한다. 이런 캡슐화 때문에 라우터는 웹페이지의 의미를 몰라도 IP 목적지에 따라 패킷을 전달할 수 있다. 수신 측은 대응하는 헤더를 해석하며 위 계층으로 내용을 넘긴다.
캡슐화는 한 응용 메시지가 항상 한 패킷이 된다는 뜻은 아니다. TCP는 바이트 스트림을 여러 세그먼트로 나눌 수 있고, 응용 프로그램의 읽기 단위도 전송 단위와 달라질 수 있다. 데이터의 의미를 이해하는 계층과 운반 단위를 결정하는 계층이 다르기 때문이다.
TCP/IP 모델에서는 보통 응용, 전송, 인터넷, 링크 계층을 구분한다. 교육용으로 링크를 물리 계층과 분리한 다섯 계층도 널리 쓰인다. OSI 모델은 물리·데이터링크·네트워크·전송·세션·표현·응용의 일곱 계층을 제공한다. 두 모델은 관점과 분할이 달라 실제 프로토콜을 숫자 하나에 억지로 맞추면 오히려 혼란스럽다.
책임을 나누면 바꿀 수 있는 것
유선 이더넷을 무선 LAN으로 바꿔도 웹 응용을 전부 다시 작성할 필요는 없다. 아래 계층이 제공하는 서비스가 충분히 유지되면 위쪽 구현이 그대로 작동할 수 있다. 오류를 찾을 때도 링크 연결, IP 도달성, TCP 연결, HTTP 응답을 차례로 확인하면 실패 위치를 좁힐 수 있다.
다만 계층화가 모든 의존성을 제거하지는 않는다. 응용의 실시간 요구는 전송 방식에 영향을 주고, 링크의 손실이나 최대 전송 크기는 위 계층의 성능에 영향을 준다. 계층을 넘는 최적화는 유용하지만 결합을 늘릴 수 있다. 좋은 계층 설계는 내부 구현을 숨기면서도 사용자가 알아야 하는 실패와 성능 조건을 드러낸다.
계층을 공부할 때는 이름보다 각 층이 맡는 범위를 먼저 적어 보는 편이 좋다. 웹 응답이 늦다는 현상만으로 HTTP 문제라고 단정할 수 없다. 이름 해석 지연, 경로 혼잡, 수신 애플리케이션 정체도 같은 현상으로 보일 수 있다. 데이터의 경로와 책임의 경계를 함께 그리면 계층화가 단순한 분류표에서 문제를 푸는 도구로 바뀐다.
서비스와 프로토콜의 차이를 더 구체적으로 보면, TCP가 응용에 제공하는 서비스는 순서 있는 바이트 스트림이다. TCP 헤더의 번호와 확인 응답 규칙은 그 서비스를 양쪽 끝점이 실현하는 방법이다. 응용은 보통 소켓 API를 통해 그 서비스를 요청하지만, 소켓 호출 자체가 네트워크를 따라 이동하는 TCP 메시지는 아니다. 한 계층의 서비스 계약이 안정적이면 내부의 구현이나 아래 계층을 바꿀 여지가 생긴다. 다만 모든 계층이 같은 신뢰성을 제공할 필요는 없다. 링크가 일부 오류를 복구해도 경로 전체에서 손실이 생길 수 있으므로 끝점의 확인이 여전히 필요하다. 장애를 처리하는 범위를 로컬 링크와 전체 연결로 나누면 같은 기능이 여러 층에 보이는 이유도 설명할 수 있다.