재귀: 작은 문제에 같은 규칙을 적용하는 실행 방식
재귀는 함수가 자신을 다시 호출하여 문제를 더 작은 문제로 바꾸는 방식이다. 코드가 자기 이름을 부른다는 사실보다, 작은 문제의 답을 이용해 큰 문제의 답을 구성한다는 점이 중요하다. 트리처럼 구조 자체가 반복되는 데이터를 다룰 때 특히 자연스럽다.
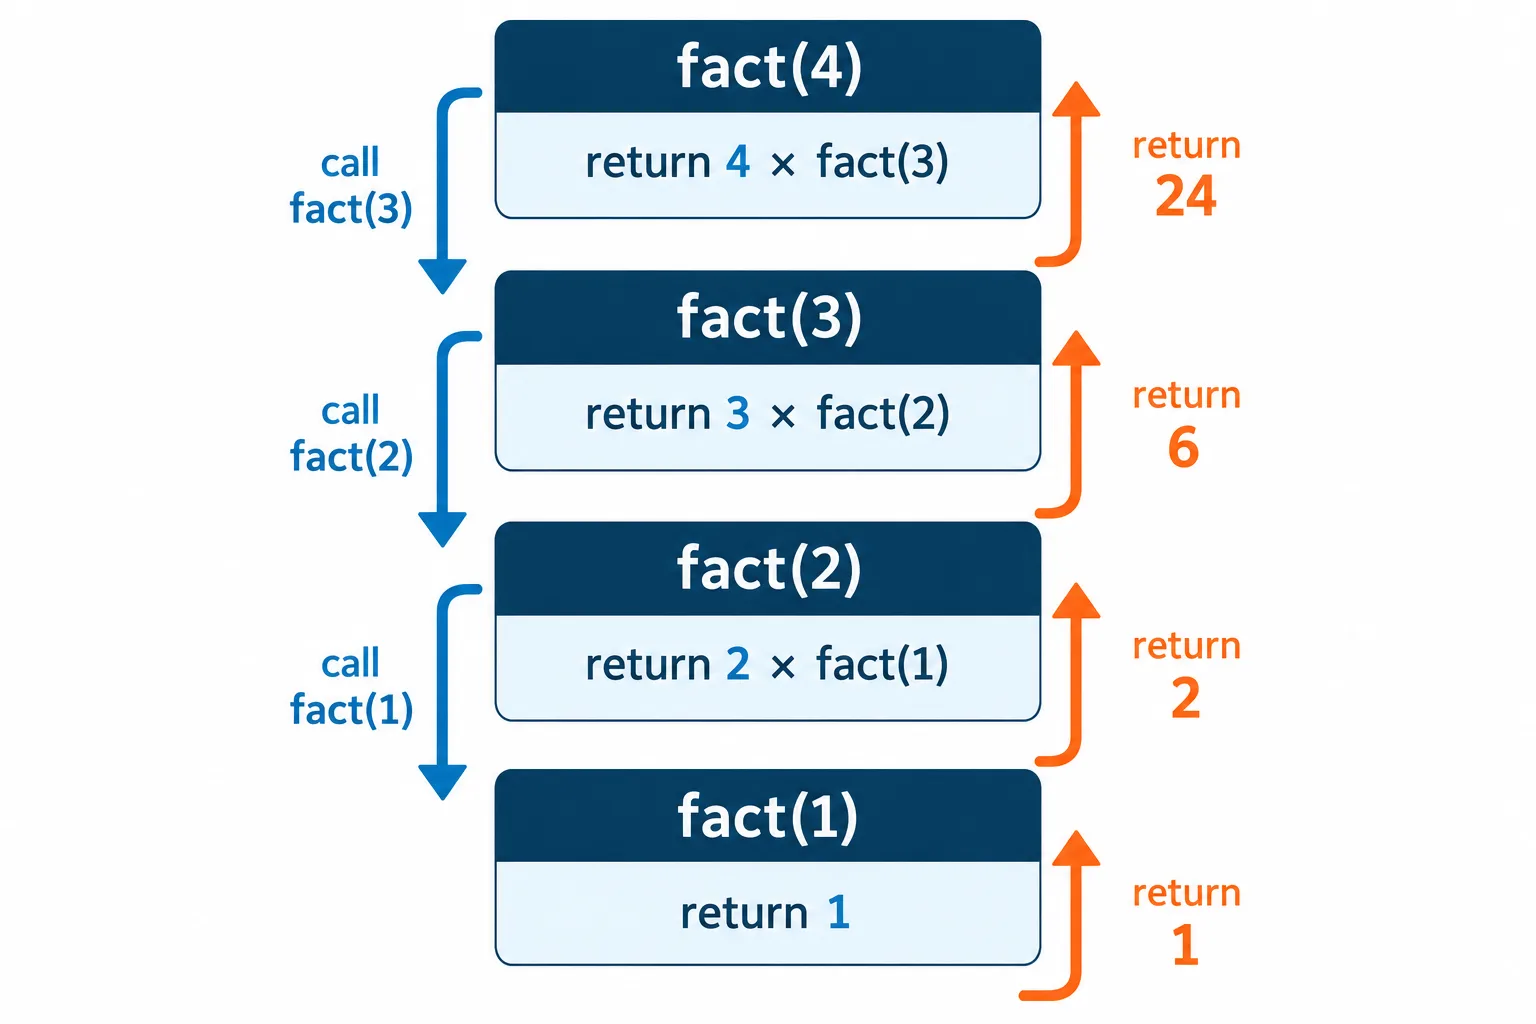
재귀 호출은 기저 사례까지 내려간 뒤 각 호출의 결과를 차례로 돌려준다.
종료 조건과 진행 조건
재귀에는 더 호출하지 않고 답을 내는 기저 조건과, 그 조건에 가까워지는 재귀 단계가 필요하다. 팩토리얼에서 0!=1을 기저로 두고 n!=n×(n-1)!을 사용하면 음이 아닌 정수 n은 호출마다 감소한다. 기저 조건이 있어도 잘못된 입력 때문에 거기에 도달하지 못하면 종료하지 않는다.
factorial(4)는 factorial(3)의 결과를 기다리고, 그 호출은 factorial(2)를 기다린다. factorial(0)이 1을 반환하면 순서대로 1, 2, 6, 24를 만들어 돌아온다. 이때 각 호출은 자신의 n과 반환할 위치를 별도로 보존한다. 같은 함수의 호출이라고 지역 변수가 하나만 공유되는 것은 아니다.
실행 환경은 이런 정보를 호출 스택에 쌓는다. 깊이가 d이고 호출마다 일정한 공간을 쓰면 스택 공간은 O(d)이다. 팩토리얼은 n단계 내려가므로 시간 O(n), 스택 O(n)이다. 큰 정수 곱셈 비용을 일정하다고 가정한 결과이므로 임의 정밀 정수의 실제 비용은 더 정교하게 분석해야 한다.
가지가 생기면 비용도 달라진다
피보나치를 F(n-1)+F(n-2)로 그대로 계산하면 같은 인자가 여러 갈래에서 반복된다. 재귀 깊이는 O(n)이지만 총호출 수는 훨씬 빠르게 증가한다. 최대 깊이와 전체 작업량을 혼동하면 시간 분석이 틀린다. 이미 구한 값을 저장하는 메모이제이션으로 중복 계산을 줄일 수 있다.
이진 트리의 노드 수를 세는 재귀는 빈 트리에 0을 반환하고, 나머지는 1+왼쪽 개수+오른쪽 개수를 반환한다. 노드마다 한 번 방문하므로 n개 노드의 시간은 O(n)이다. 공간은 트리 높이 h에 따라 O(h)이며, 균형 트리와 한쪽으로 기운 트리는 차이가 크다.
정확성은 작은 입력에서 규칙이 맞는지 확인하고, 더 작은 입력에서 올바른 답을 얻는다고 가정했을 때 현재 입력의 답도 맞는지 보이면 설명할 수 있다. 이 구조는 수학적 귀납법과 닮았지만 종료를 보이는 일도 따로 필요하다.
재귀는 가독성을 높일 수 있지만 깊은 입력에서는 스택 한도를 넘는다. 꼬리 재귀가 언제나 반복문처럼 최적화되는 것도 아니다. 언어의 보장과 실행 환경을 확인하고, 필요하면 명시적 스택이나 반복문으로 바꾸는 것이 안전하다.
반복 구조를 그대로 함수로 표현하기
트리의 노드 수를 세는 코드는 부분트리라는 데이터 구조와 재귀 구조가 정확히 대응한다.
def count_nodes(root):
    if root is None:
        return 0
    left_count = count_nodes(root.left)
    right_count = count_nodes(root.right)
    current_node_count = 1
    return current_node_count + left_count + right_count
이 함수는 루트가 사이클 없는 트리를 나타낸다고 가정한다. 같은 노드로 돌아가는 참조가 있으면 끝나지 않을 수 있고, 두 경로가 같은 노드를 공유하면 두 번 센다. 재귀를 쓸 때 데이터의 구조적 전제까지 확인해야 한다.