참조 지역성: 자료를 언제 어디서 다시 쓰는지가 성능을 바꾼다
프로그램은 메모리 전체를 균일하게 무작위로 사용하는 경우보다 작은 부분을 반복하거나 가까운 데이터를 이어서 접근하는 경우가 많다. 참조 지역성은 이런 접근의 집중성을 나타내는 개념이다. 시간적 지역성은 최근 쓴 것을 곧 다시 쓰는 경향이고, 공간적 지역성은 사용한 위치 근처를 곧 쓰는 경향이다. 캐시와 여러 저장 계층은 이 경향을 이용한다.
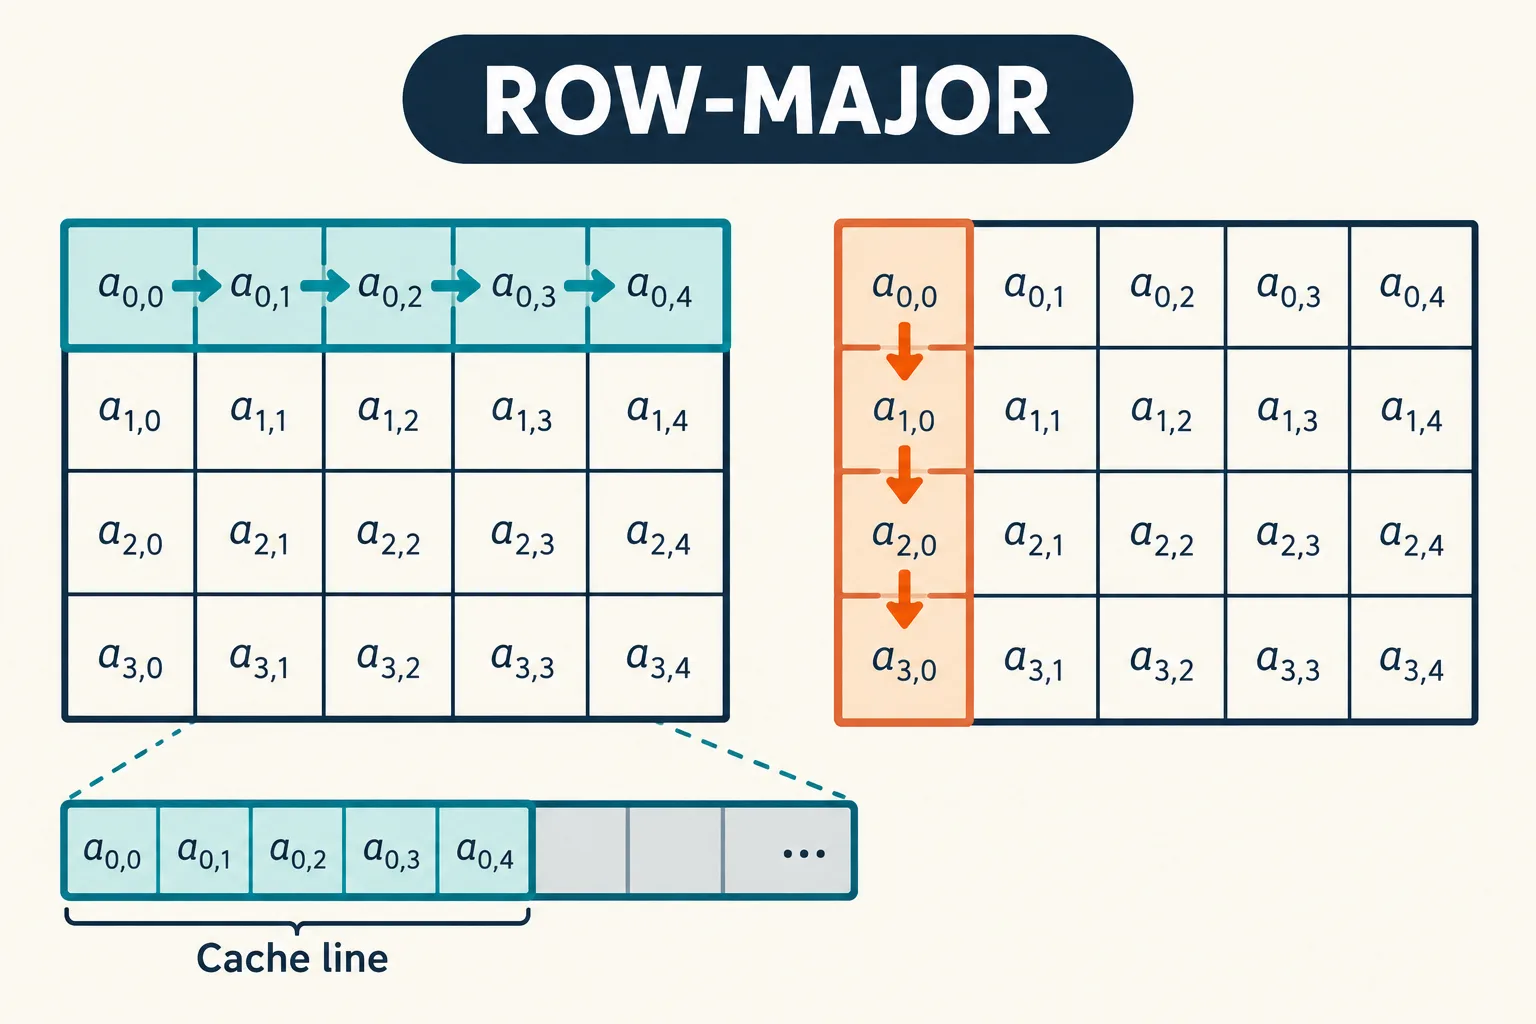
실제 저장 배치에 맞춘 방문 순서가 캐시 라인의 재사용을 높일 수 있다.
반복과 이웃 접근은 다른 기회
반복문에서 작은 누적 변수나 같은 표를 계속 읽으면 시간적 지역성이 생긴다. 배열 원소를 차례대로 읽으면 공간적 지역성이 생긴다. 캐시는 한 블록을 가져와 재사용하고 주변 값을 함께 준비한다. CMU의 메모리 계층 수업은 두 지역성과 저장 계층의 관계를 설명한다. 어느 하나가 좋다고 항상 다른 하나도 좋은 것은 아니다.
큰 배열을 한 번만 순서대로 읽으면 공간적 지역성은 좋지만 같은 값을 다시 읽는 시간적 재사용은 적다. 작은 배열을 불규칙한 순서로 여러 번 읽으면 주소 이웃을 충분히 쓰지 않아도 작업 집합이 캐시에 들어갈 수 있다. 지역성을 평가할 때는 단순히 순서가 규칙적인지보다 어떤 크기의 데이터를 얼마나 가까운 시간에 재사용하는지 봐야 한다.
행과 열을 읽는 순서
행 우선으로 저장된 2차원 배열에서 한 행의 원소들은 가까이 배치된다. 행을 먼저 고르고 열을 연속적으로 진행하면 가져온 캐시 라인의 이웃 원소를 쓰기 쉽다. 반대로 같은 열을 따라 행 번호를 바꾸면 행 길이만큼 주소가 크게 뛰며 다른 라인을 자주 찾는다. 같은 원소를 같은 횟수 읽어도 저장 배치와 방문 순서가 달라 비용이 달라진다.
이 차이는 배열 크기와 캐시, 라인 크기, 미리 가져오기 기능에 영향을 받는다. 작은 배열이 이미 캐시에 들어 있다면 두 방식의 차이가 작을 수 있다. 언어와 라이브러리가 열 우선 배치를 사용하는 경우에는 유리한 순서가 바뀐다. 행 순회가 언제나 빠르다는 규칙보다 실제 물리 배치에 맞춰 방문한다는 원리가 중요하다.
작은 영역에서 충분히 계산한다
행렬 연산을 작은 타일로 나누면 해당 조각의 자료를 캐시에 둔 채 여러 연산에 재사용할 수 있다. 이를 블로킹이라고 한다. 전체 데이터를 한 번에 번갈아 훑는 것보다 재사용 사이의 다른 접근을 줄인다. 타일이 너무 크면 캐시에서 밀려나고 너무 작으면 반복과 관리 비용이 늘 수 있어 대상 구조와 연산을 고려해야 한다.
포인터 기반 연결 구조는 논리적으로 이웃한 객체가 메모리에서도 가까이 있다는 보장이 없다. 순회할 때마다 새로운 곳을 읽고 다음 주소도 앞 결과에 의존할 수 있다. 같은 기능을 연속 배열로 표현하면 공간적 지역성과 미리 가져오기에 유리할 수 있다. 하지만 삽입·삭제 비용과 안정적인 참조 같은 다른 요구도 있으므로 자료구조 선택에는 균형이 필요하다.
지역성은 CPU 데이터 캐시만의 문제가 아니다. 코드 접근, TLB의 주소 변환, 파일 시스템 캐시와 저장 장치 접근에서도 재사용과 가까운 배치가 의미를 가진다. 한 단계에서 좋은 패턴이 다른 단계에서도 반드시 완벽하지는 않지만, 자주 쓰는 활성 영역을 작게 유지하는 관점은 널리 유용하다.
성능을 개선하려면 먼저 실제 접근 패턴과 활성 작업 집합을 관찰한다. 원소 수를 줄이지 않아도 배치와 순서를 바꾸면 같은 정보를 더 가까운 시간과 위치에서 재사용할 수 있다. 참조 지역성은 알고리즘의 연산 횟수와 실제 메모리 비용 사이를 연결하는 개념이며, 컴퓨터가 데이터를 어디에 보관하고 언제 다시 쓰는지를 함께 생각하게 한다.