캐시 메모리: 작은 저장소가 큰 RAM보다 빠르게 느껴지는 이유
CPU가 매번 큰 RAM에서 데이터를 기다리면 빠른 계산 장치가 자주 빈손으로 남는다. 캐시는 최근 사용했거나 곧 사용할 가능성이 높은 데이터를 더 작고 빠른 저장소에 보관한다. 필요한 내용이 캐시에 있으면 히트, 없으면 미스다. 여러 단계의 캐시와 메모리를 결합해 대부분의 접근을 빠르게 처리하면서 큰 용량도 제공하려는 구조다.
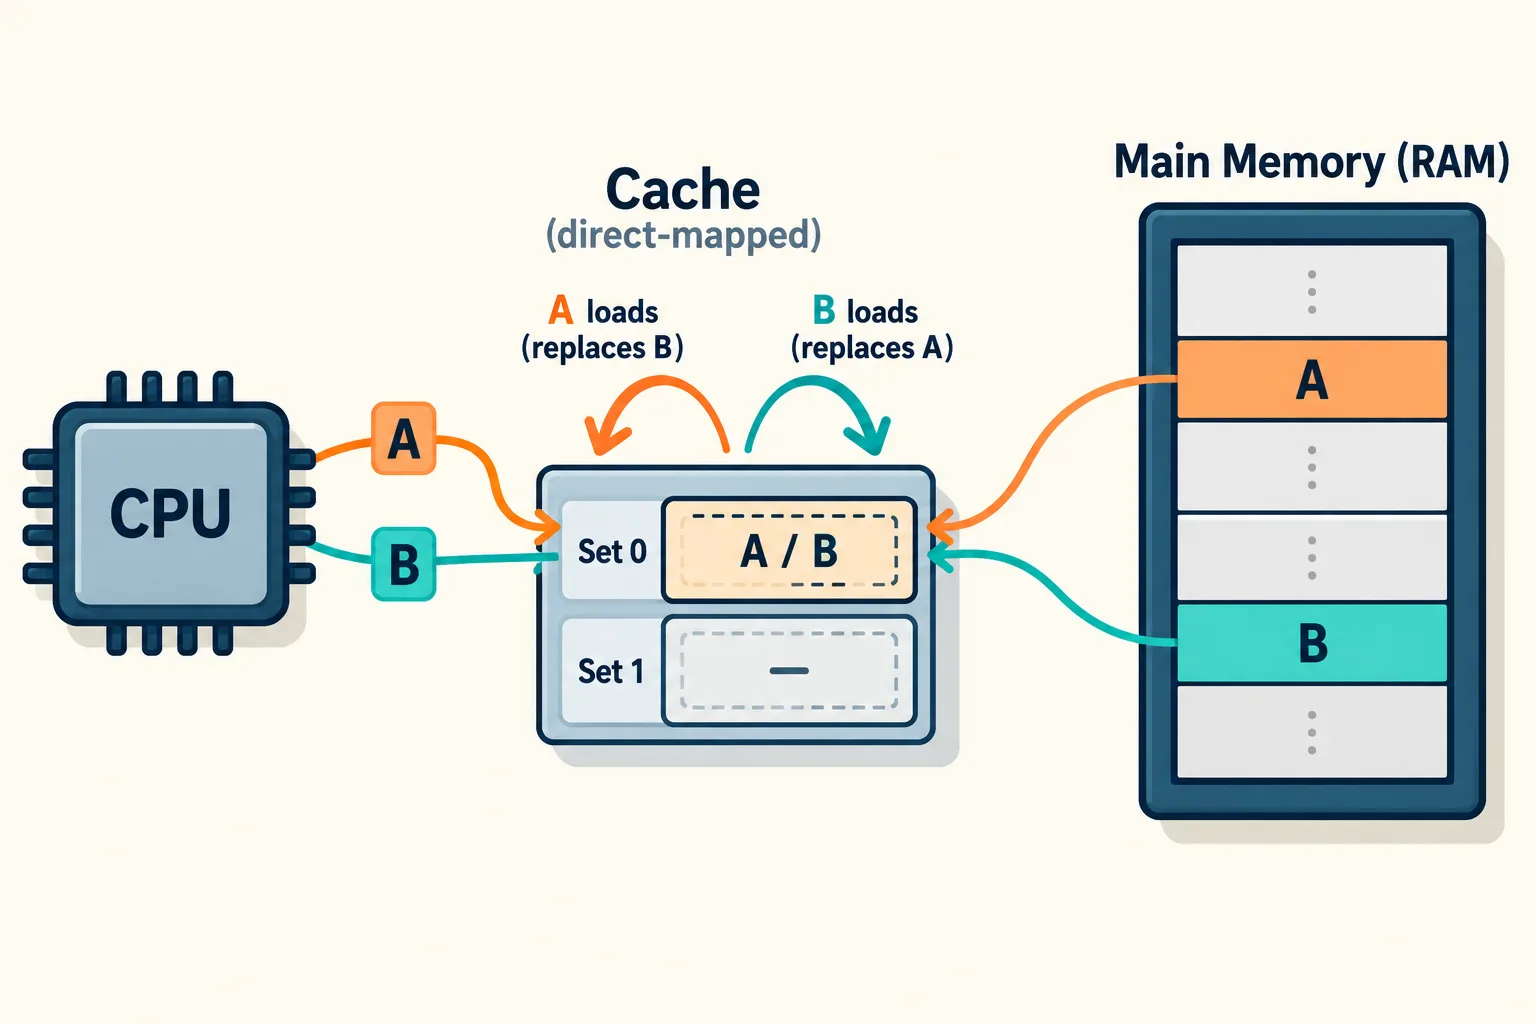
캐시 미스는 용량 부족뿐 아니라 배치 충돌 때문에도 발생한다.
하나의 값보다 블록을 가져온다
CPU 캐시는 보통 캐시 라인이라는 일정 크기 블록을 저장한다. 원소 하나를 읽을 때 주변 데이터도 함께 준비할 수 있어 연속 접근에 유리하다. 설명용으로 라인이 64바이트이고 원소가 8바이트라면 한 라인에 여덟 원소가 들어간다. 실제 라인 크기는 대상 구조를 확인해야 하며, 예제 숫자를 모든 CPU의 공통값으로 받아들이면 안 된다.
캐시의 주소 해석에는 블록 안의 오프셋, 저장할 세트의 번호, 어떤 메모리 블록인지 식별하는 태그 등이 쓰인다. 직접 매핑은 각 블록이 들어갈 자리가 하나이고, 세트 연관 구조는 같은 세트 안의 여러 자리 중에 들어간다. CMU의 캐시 수업 자료는 주소와 캐시 구성의 관계를 설명한다.
용량이 남아도 충돌할 수 있다
직접 매핑 캐시에서 주소 A와 B가 같은 자리에 연결된다고 하자. A를 읽어 채운 뒤 B를 읽으면 A가 밀려나고, 다시 A를 읽으면 또 미스가 된다. 다른 자리들이 비어 있어도 둘이 번갈아 실패할 수 있다. 이런 충돌 미스는 전체 작업 집합이 캐시보다 커서 생기는 용량 미스와 구분한다. 처음 보는 블록의 필수 미스도 별도의 원인이다.
연관도를 높이면 같은 세트의 여러 블록을 함께 보관해 충돌을 줄일 수 있지만, 태그 비교와 교체 선택이 복잡해진다. 캐시를 크게 만드는 것도 접근 지연과 전력, 면적에 영향을 준다. 어떤 블록을 내보낼지 결정하는 정책은 재사용 패턴을 예측해야 한다. 크기 하나만으로 실제 작업의 히트율이 결정되지 않는다.
쓰기를 언제 아래에 전달할까
쓰기 관통은 변경을 다음 메모리 단계에도 전달하는 방식이고, 쓰기 되돌림은 캐시에서 변경한 뒤 필요할 때 내려보내는 방식이다. 되돌림에서는 수정된 라인임을 기록한다. 쓰기 미스 때 먼저 블록을 가져올지 바로 아래로 전달할지도 별도의 정책이다. 여러 코어가 있다면 같은 데이터의 다른 캐시 복사본을 관리하는 일관성 규칙도 참여한다.
평균 접근 시간의 단순 모델은 히트 시간에 미스율과 추가 미스 비용의 곱을 더한다. 예를 들어 히트 2ns, 미스율 5%, 추가 비용 80ns라면 평균은 6ns다. 이는 설명용 가정이며 동시 요청, 여러 캐시 단계, 겹친 실행을 생략한다. 작은 미스율이라도 실패 비용이 크면 전체 성능을 지배할 수 있다는 점을 보여 준다.
캐시를 잘 쓰려면 자료를 접근 순서에 맞게 배치하고, 작은 활성 영역에서 값을 재사용하는 것이 유리하다. 하지만 미리 가져오기와 비순차 실행이 대기를 가리는 정도도 영향을 준다. 캐시 미스 통계만으로 최종 지연을 전부 설명하지는 못한다. 캐시는 데이터 재사용이라는 기회를 저장하고, 프로그램의 패턴이 그 기회를 실제 이득으로 바꾸는 장치다.