컴파일러는 소스 코드를 무엇으로, 어떤 약속 아래 바꿀까
컴파일러는 한 언어로 표현된 프로그램을 다른 표현으로 변환하는 도구다. 흔히 소스 코드를 기계어로 만든다고 설명하지만 결과가 중간 코드, 바이트코드, 다른 언어의 소스일 수도 있다. 핵심은 입력 프로그램의 규정된 의미를 보존하며 실행이나 후속 변환에 적합한 형태를 만드는 것이다. 단순한 문자열 치환보다 구조와 규칙에 대한 분석이 필요하다.
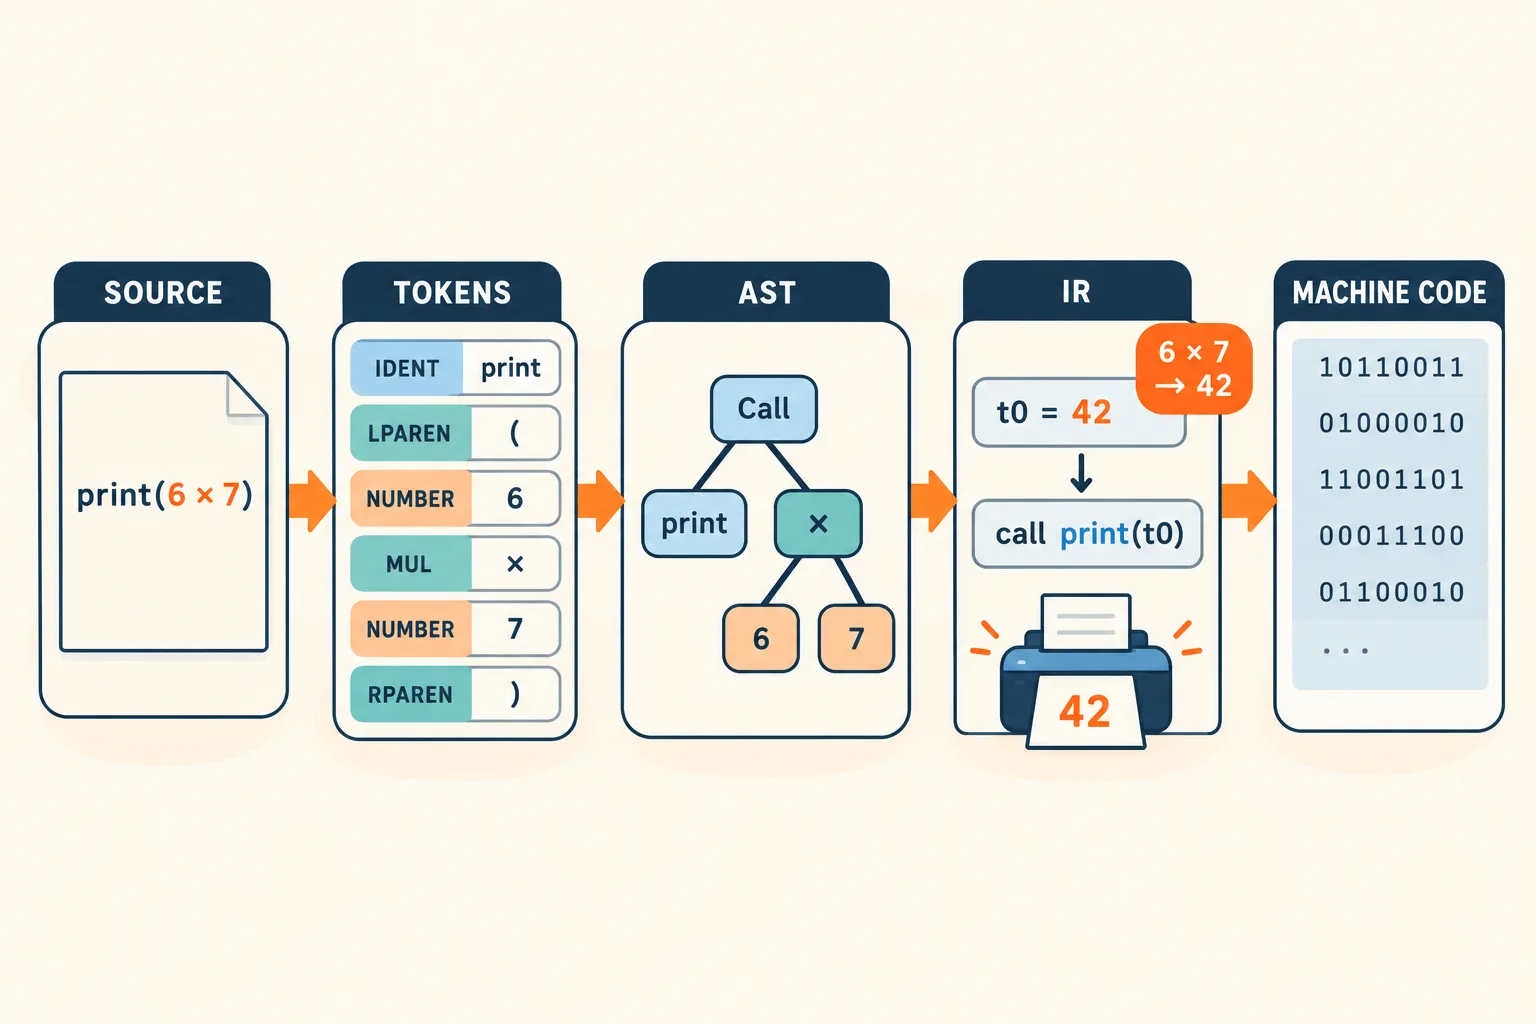
컴파일러는 구조를 분석하고 의미를 지키면서 실행에 적합한 표현으로 변환한다.
문자를 실행 구조로 바꾼다
전형적인 앞부분에서는 문자들을 토큰으로 나누고 문법에 따라 구문 구조를 만든다. 이름이 어느 선언을 뜻하는지, 연산의 타입이 맞는지 등 의미 분석도 수행한다. 언어마다 단계의 구분과 구현은 다르지만 문법적으로 쓸 수 있다는 사실과 올바른 의미라는 사실을 구분한다. 선언되지 않은 이름이나 허용되지 않는 연산은 여기서 발견될 수 있다.
프로그램은 이후 중간 표현으로 내려갈 수 있다. 중간 표현은 제어 흐름과 값 계산을 변환하기 쉬운 규칙으로 나타낸다. LLVM의 언어 구현 튜토리얼은 어휘 분석, 구문 트리, 중간 표현, 코드 생성과 최적화를 연결하는 예를 제공한다. 모든 컴파일러가 LLVM을 쓰거나 같은 중간 표현을 쓰는 것은 아니다.
실행 전에 가능한 계산
x = 6 * 7처럼 의미가 확정된 상수 계산을 컴파일 시점에 42로 바꾸면 실행할 일을 줄일 수 있다. 사용하지 않는 값을 제거하고 반복되는 계산을 재사용하는 변환도 가능하다. 그러나 어떤 코드가 관찰 가능한 결과를 만드는지 먼저 분석해야 한다. 화면 출력이나 파일 쓰기가 있다면 결과 변수만 쓰이지 않는다고 그 작업 전체를 없애서는 안 된다.
최적화는 수학식 변형과 항상 같지 않다. 부동소수점의 더하기 순서를 바꾸면 반올림 결과가 달라질 수 있다. 정수 범위 밖 동작과 별칭 포인터, 예외, 동시성 규칙도 허용되는 변환에 영향을 준다. 프로그램이 정의된 동작의 범위 안에 있어야 컴파일러의 의미 보존 계약을 정확히 해석할 수 있다.
목표 CPU에 맞춰 배치한다
뒷부분은 목표 아키텍처의 명령을 고르고 레지스터를 배정하며 필요하면 값을 메모리에 저장한다. 함수 호출 규약과 스택 구성, 분기와 코드 배치도 관련된다. 같은 소스라도 목표 ISA와 최적화 설정이 다르면 기계 명령과 성능이 달라진다. 소스의 한 줄이 기계 명령 하나와 항상 대응하지 않는 이유다.
컴파일과 링크도 구분해야 한다. 컴파일은 개별 프로그램 단위의 변환을 수행하고, 링크는 다른 단위나 라이브러리의 기호를 연결해 실행 가능한 결과를 구성한다. 실행 시 로딩과 동적 연결이 남을 수도 있다. 컴파일 오류, 링크 오류, 실행 오류는 서로 다른 단계에서 발견된 문제다.
미리 컴파일하는 AOT와 실행 중 컴파일하는 JIT는 변환 시점이 다르다. JIT는 실제 실행 정보로 자주 쓰는 경로를 선택할 수 있지만 시작 비용과 코드 관리 부담이 있다. 같은 실행 환경이 해석과 컴파일을 함께 사용할 수도 있다. 언어 이름만으로 하나의 방식으로 실행된다고 단정하지 않는 편이 정확하다.
컴파일러를 이해하면 최적화가 코드를 어떻게 바꿨는지, 디버거에서 소스와 실행 위치가 왜 어긋나는지 설명할 수 있다. 성능을 개선할 때는 생성 결과와 실제 측정을 살펴야 한다. 컴파일러는 프로그램의 의미와 목표 장치의 제약 사이를 연결하는 변환 시스템이며, 빠른 코드라는 목표도 정확한 의미 위에서 성립한다.