퀵 정렬: 피벗 선택과 분할 모양이 성능을 바꾸는 과정
퀵 정렬은 피벗을 기준으로 작은 원소와 큰 원소를 나누고, 각 부분을 다시 정렬한다. 피벗이 최종 위치에 놓이거나 피벗과 같은 구간이 확정되면 그 부분은 다시 정렬할 필요가 없다. 핵심은 원소를 어떤 분할 규칙으로 배치하는가다.
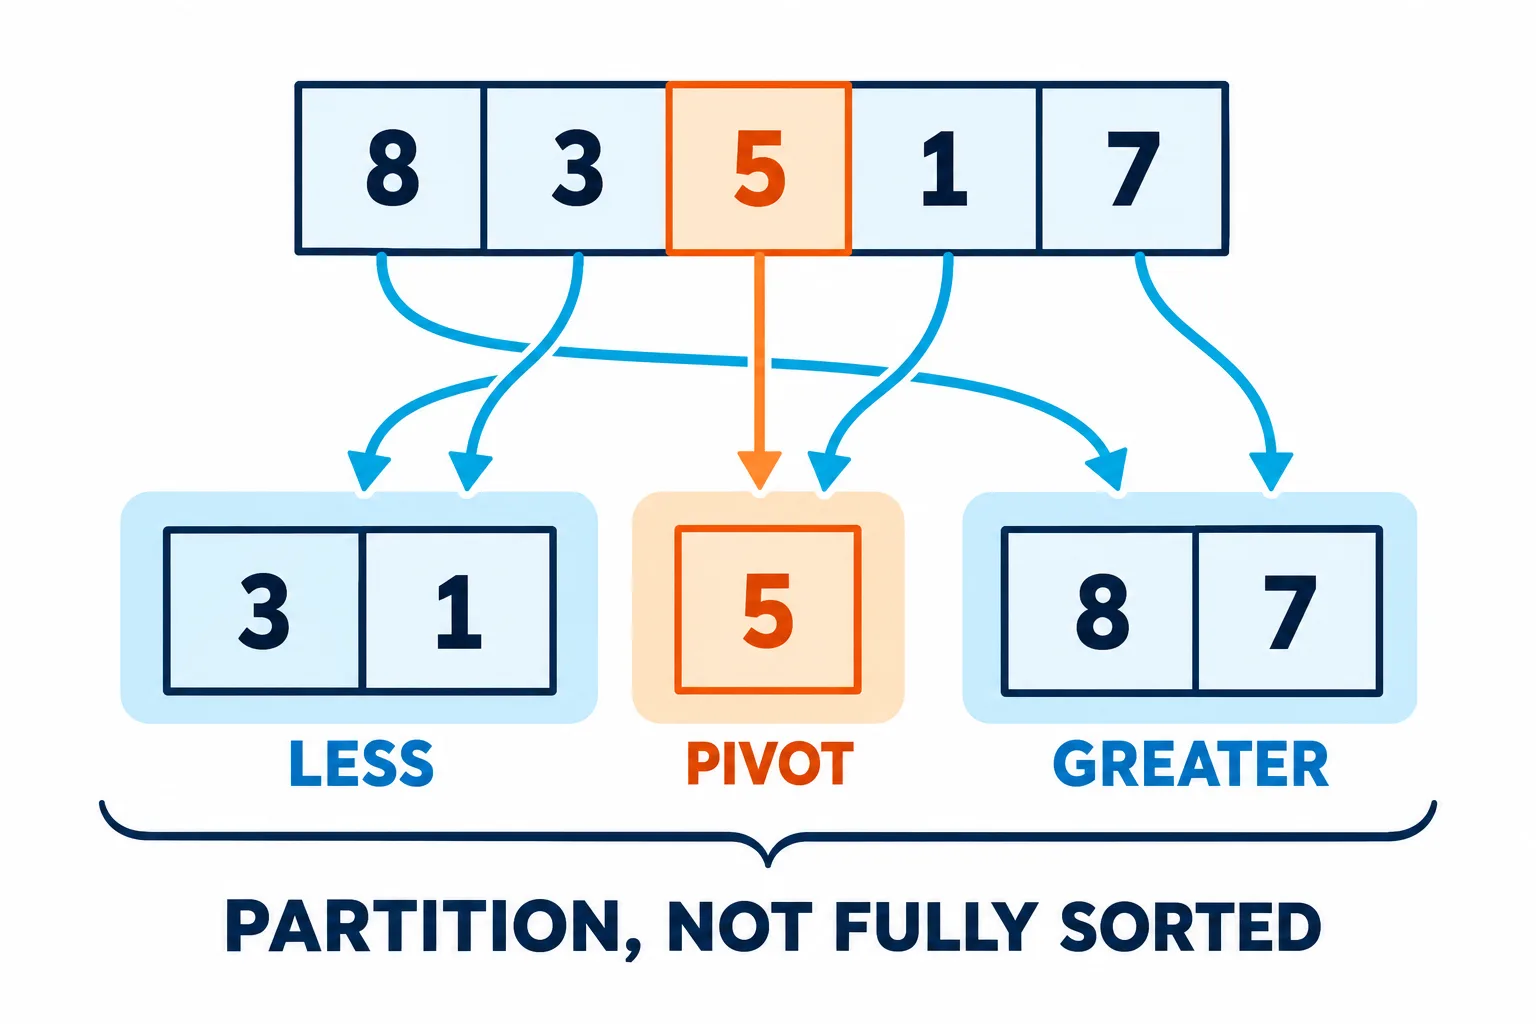
분할 직후 양쪽 구간 내부까지 정렬된 것은 아니다.
간단한 분할을 정확히 읽기
다음 Lomuto 분할은 반열린 구간 [start,end)의 마지막 값을 피벗으로 쓴다. 경계 앞은 피벗보다 작거나 같은 원소, 경계 뒤에서 현재 검사 위치 앞은 큰 원소라는 불변식을 유지한다.
def partition(values, start, end):
    pivot = values[end - 1]
    boundary = start
    for scan in range(start, end - 1):
        if values[scan] <= pivot:
            values[boundary], values[scan] = values[scan], values[boundary]
            boundary += 1
    values[boundary], values[end - 1] = values[end - 1], values[boundary]
    return boundary
호출자는 길이가 2 이상일 때 분할하고, 피벗 위치 p를 제외한 [start,p), [p+1,end)를 처리한다. p를 다시 포함하면 종료가 안 될 수 있다. Hoare 방식은 반환 경계의 의미가 달라 같은 재귀 범위를 그대로 사용할 수 없다.
[4,1,3,2]에서 피벗 2를 쓰면 1이 왼쪽으로, 3과 4는 오른쪽으로 가고 2가 두 부분 사이에 자리 잡는다. 내부 구간은 아직 정렬되지 않았지만 양쪽과 피벗 사이의 순서 관계는 확보됐다.
평균이 빠르고 최악이 느린 이유
분할이 균형 잡히면 T(n)=2T(n/2)+O(n)으로 O(n log n)이다. 매번 한쪽에 n-1개가 남으면 n+(n-1)+… 작업을 하여 O(n²)이다. 마지막 원소 피벗으로 이미 정렬된 배열을 처리하면 이런 나쁜 분할이 반복될 수 있다.
무작위 피벗은 입력 순서와 나쁜 선택의 상관을 줄여 기대 O(n log n)을 얻는다. 최악 O(n²) 가능성이 사라진다는 뜻은 아니다. 같은 값이 많은 입력에는 작은 값·같은 값·큰 값 세 구간으로 나누는 방식이 효과적이다.
배열의 원소를 교환하는 전형적 구현은 데이터 보조 공간이 작지만 호출 스택은 평균 O(log n), 최악 O(n)이 될 수 있다. 작은 쪽만 재귀하고 큰 쪽을 반복 처리하면 스택 깊이를 제한할 수 있다. 보통 원소 교환으로 동일 키 순서가 바뀌어 안정 정렬은 아니다.
실제 라이브러리는 작은 구간 처리, 피벗 전략, 깊이 제한 뒤 다른 정렬로 전환하는 기법을 결합한다. 퀵 정렬을 평가할 때는 이름 하나보다 분할 규칙과 중복 키 처리, 최악 입력 대응을 확인해야 한다.
피벗과 같은 값을 항상 한쪽에 보내면 모든 원소가 같은 배열에서도 분할이 퇴화할 수 있다. 랜덤 피벗만으로 중복 키 문제가 모두 해결되지는 않는다.