큐: 도착 순서를 보존하면서 앞뒤를 관리하는 자료형
큐는 먼저 들어온 원소를 먼저 꺼내는 선입선출 자료형이다. FIFO 규칙은 작업을 도착 순서로 처리할 때 자연스럽다. enqueue는 뒤에 추가하고 dequeue는 앞에서 제거한다. 가장 앞 원소를 읽는 연산도 제공할 수 있다.
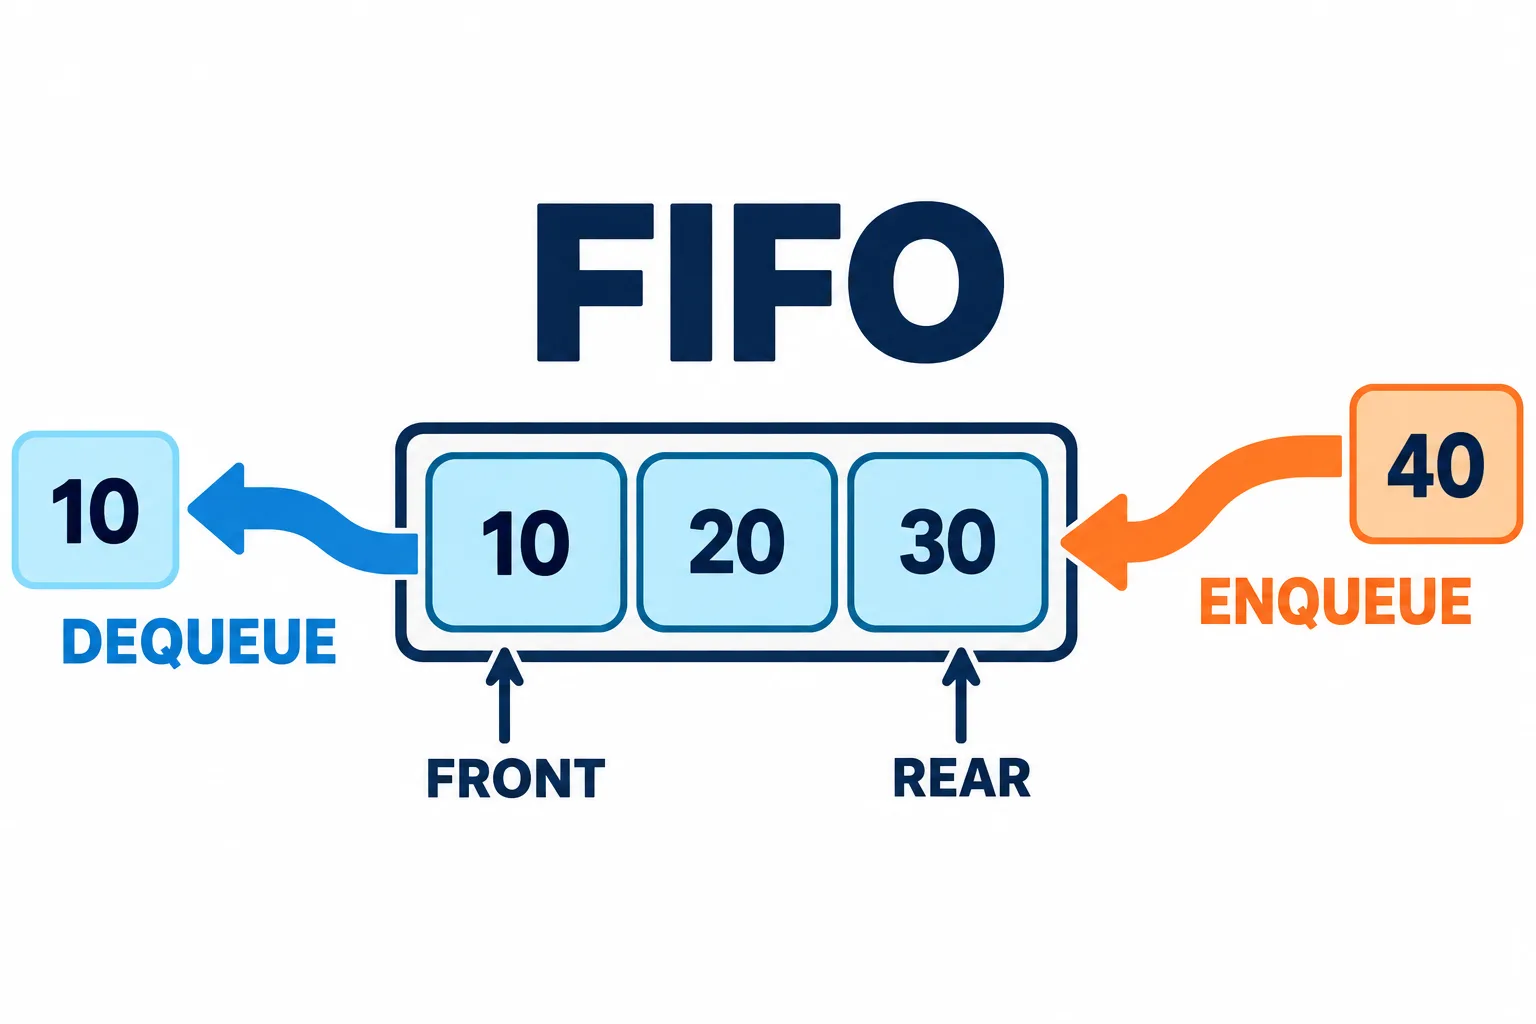
먼저 들어온 원소가 앞쪽에서 먼저 나온다.
순서를 유지하는 두 끝
A, B, C 순서로 들어온 작업이 있다면 dequeue는 A를 반환한다. D를 추가하면 남은 상태는 B, C, D이고 다음 반환은 B다. 새 작업이 들어와도 기존 작업보다 앞에 끼어들지 않는다는 규칙이 스택이나 우선순위 큐와 구별된다.
단순 배열에서 매번 첫 원소를 지우고 나머지를 앞으로 당기면 dequeue가 O(n)이 된다. 큐의 동작은 맞더라도 효율적인 구현은 아니다. 앞 위치를 나타내는 인덱스를 이동하거나 원형 배열을 사용하면 전체 이동 없이 처리할 수 있다.
연결 리스트 구현은 head와 tail을 함께 유지한다. 추가할 때 tail 뒤에 새 노드를 연결하고, 제거할 때 head를 다음 노드로 바꾼다. 마지막 원소를 제거하면 head와 tail이 모두 비어야 한다. tail이 이미 해제된 노드를 가리키는 상태를 남기면 이후 삽입이 잘못된다.
큐의 상태를 단계별로 보기
프린터에 보고서 A와 사진 B가 대기 중이라고 하자. A가 시작되면서 큐에서 빠지고, 실행 중 새 문서 C가 도착하면 큐는 B, C가 된다. 실행 중 작업과 대기 큐에 들어 있는 작업을 구분하면 길이와 처리 완료 시점을 혼동하지 않는다.
폭이 넓어지는 순서로 정점을 찾는 너비 우선 탐색도 큐를 쓴다. 먼저 발견된 가까운 정점을 먼저 처리해야 그 이웃이 올바른 다음 거리 층으로 들어간다. 작업의 선후 관계를 보존하는 큐 규칙이 탐색의 정확성에 영향을 준다.
적절한 연결 구조나 원형 배열에서는 양끝 작업이 O(1)이다. 동적 배열 기반이면 확장 때 복사가 있어 분할 상환 보장으로 표현할 수 있다. 검색이나 가운데 삭제는 큐의 핵심 연산이 아니며, 이를 자주 요구하면 다른 자료구조를 검토해야 한다.
현실의 작업 큐에는 용량, 대기 정책, 취소, 우선순위도 붙는다. 가득 찼을 때 생산자를 기다리게 할지 새 작업을 버릴지 결정해야 한다. 여러 스레드가 함께 사용한다면 FIFO 규칙만으로 안전한 동시 접근이 보장되지는 않으며, 상태 변경을 보호하는 방식이 필요하다.
효율적인 양끝 연산을 사용하기
from collections import deque

waiting = deque()
waiting.append("report A")
waiting.append("photo B")
current_job = waiting.popleft()
waiting.append("document C")
# current_job is report A.
# Waiting order is photo B, document C.
대기 목록이 비어 있으면 popleft가 실패하므로 호출 전 확인하거나 API의 예외를 처리한다. 위 모형에서 처리 중인 작업을 다시 큐에 넣으면 중복 실행될 수 있다. 실제 작업 시스템에서는 대기, 실행 중, 완료 상태를 별도로 관리하고 실패 재시도의 의미까지 정의해야 한다.