트라이: 문자열을 접두사 구조로 저장하는 방법
트라이는 문자열의 문자를 경로로 저장하는 트리다. 한 단어가 하나의 노드가 되는 대신, 루트에서 내려가며 읽은 간선 문자가 문자열을 이룬다. 여러 단어가 같은 접두사를 갖는다면 그 경로를 공유한다.
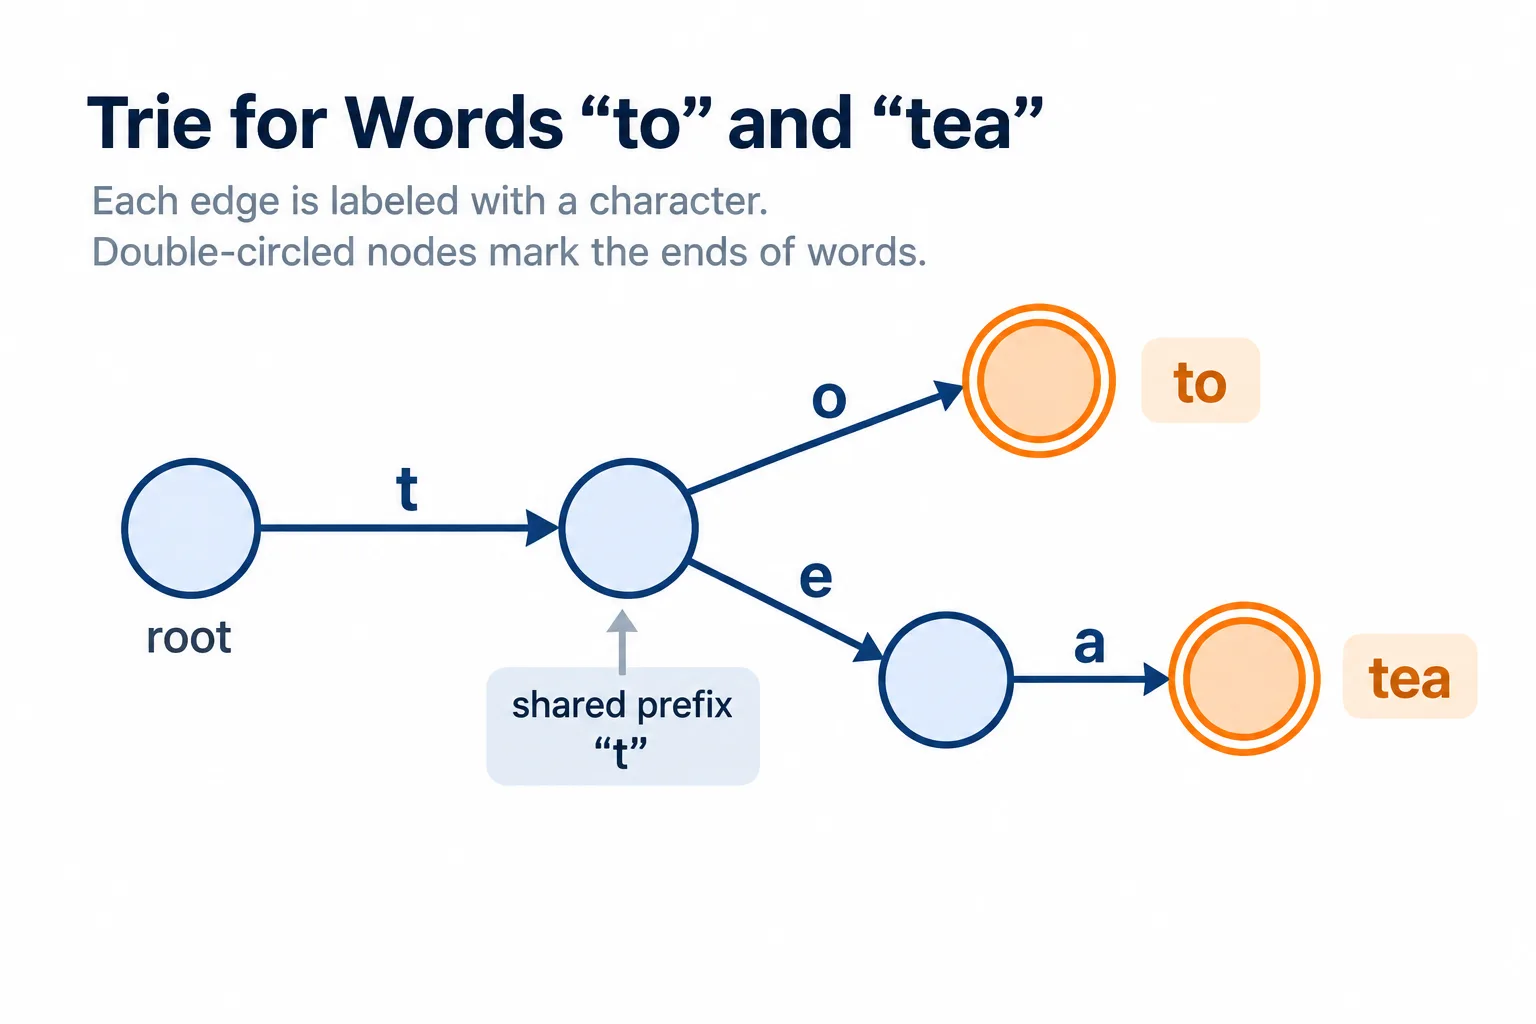
문자의 경로가 존재하는 것과 완전한 단어가 저장된 것은 다르다.
단어의 끝을 따로 표시하기
car, cat, care를 저장하면 c→a까지는 공통이고 r과 t에서 갈라진다. r 노드는 car의 끝이면서 care의 경로 중간이기도 하다. 그래서 자식이 없다는 사실만으로 단어의 끝을 판단할 수 없다. terminal 같은 종료 표식이 필요하다.
car를 검색할 때 c, a, r 간선을 따라간 뒤 종료 표식이 있는지 확인한다. ca는 경로가 있지만 단어로 넣지 않았다면 검색 실패다. 접두사 검색은 달라서 ca 노드에 도달하기만 하면 그 아래에 여러 후보가 있다는 사실을 알 수 있다.
삽입은 경로를 만들고 끝을 표시한다
아래 코드는 각 노드의 children을 문자→자식 딕셔너리로 둔 단순 구현이다. Node가 빈 children과 false인 terminal을 만든다고 가정한다.
def insert(root, word):
    current_node = root
    for character in word:
        if character not in current_node.children:
            current_node.children[character] = Node()
        current_node = current_node.children[character]
    current_node.terminal = True

def contains(root, word):
    current_node = root
    for character in word:
        if character not in current_node.children:
            return False
        current_node = current_node.children[character]
    return current_node.terminal
자식 찾기가 일정 시간이라고 가정하면 길이 L 단어의 삽입·검색은 O(L)이다. 딕셔너리라면 기대 비용이고, 자식을 정렬 구조로 저장하면 알파벳 크기에 따른 추가 비용이 있다. 단어 수 n만으로 검색 비용을 표현하는 것보다 읽는 문자 수가 직접적인 기준이다.
접두사 자동완성은 접두사 노드까지 간 뒤 하위 트리를 순회한다. 후보를 실제로 출력하는 데는 결과 크기만큼 비용이 든다. 접두사만 찾는 O(L)을 전체 자동완성 출력 비용으로 오해하면 안 된다.
각 노드에 알파벳 크기의 배열을 두면 빠른 대신 빈 참조 공간이 많아진다. 딕셔너리나 경로 압축을 쓰면 공간을 줄일 수 있지만 구현과 비교 방식이 달라진다. 유니코드 문자열은 문자, 코드 포인트, 바이트 중 어느 단위를 경로에 쓰는지도 결정해야 한다.
트라이는 사전, 접두사 매칭, 라우팅의 비트 프리픽스 처리 등에 어울린다. 문자열 전체의 정확한 조회만 필요하고 접두사를 거의 쓰지 않는다면 해시 테이블이 더 간단할 수 있다. 공유 경로의 이점과 노드 관리 비용을 함께 비교해야 한다.