해시 테이블: 키를 빠르게 찾기 위한 약속과 예외
해시 테이블은 키에 해시 함수를 적용해 저장 위치를 결정하는 자료구조다. 이름, ID처럼 순서가 필요하지 않은 키로 값을 찾을 때 유용하다. 해시 함수가 같은 키에 일관된 결과를 내는 것과, 다른 키들을 여러 위치에 잘 퍼뜨리는 것이 중요하다.
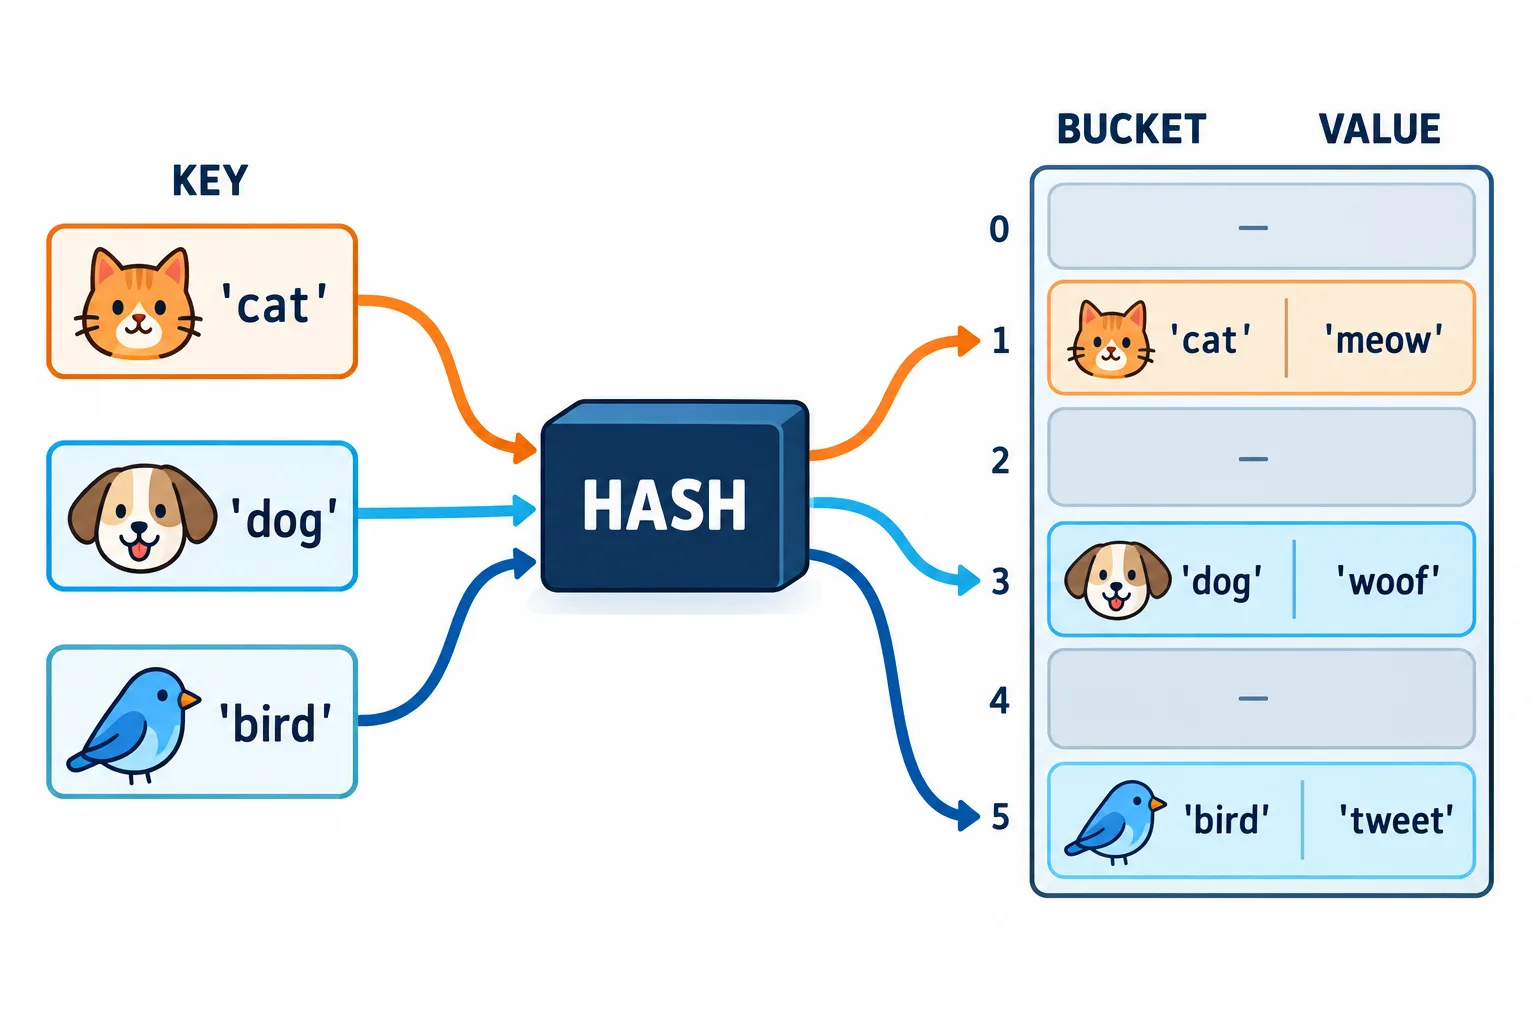
그림의 버킷 배치는 설명용 예시이며 모든 키가 다른 버킷에 들어간다는 보장은 아니다.
해시가 같아도 키는 다를 수 있다
버킷이 m개라면 h(key) mod m처럼 인덱스를 얻는다. 키의 종류가 버킷 수보다 많으므로 서로 다른 키가 같은 위치를 받는 충돌은 피할 수 없다. 해시값이 같다는 이유만으로 같은 키로 판단하면 틀린 값을 반환한다. 실제 키의 동등성 검사와 충돌 해결이 필요하다.
체이닝 방식은 한 버킷에 여러 항목을 연결한다. 개방 주소법은 배열 안의 다른 빈칸을 정해진 순서로 찾는다. 따라서 해시 테이블은 단순한 배열에 해시값만 넣는 구조가 아니라, 검색이 삽입과 같은 경로를 따라가도록 설계된 저장 체계다.
검색의 마지막 단계는 비교다
다음은 버킷마다 항목 목록을 가진 단순한 검색 예다. 부가 작업을 생략한 교육용 코드이며 buckets에는 현재의 모든 키가 올바른 버킷에 저장되어 있다고 가정한다.
def lookup(buckets, key, hash_function):
    bucket_index = hash_function(key) % len(buckets)
    candidate_entries = buckets[bucket_index]
    for stored_key, stored_value in candidate_entries:
        if stored_key == key:
            return stored_value
    raise KeyError(key)
회원 ID 42와 105가 같은 버킷으로 가도 두 키를 비교하면 원하는 값을 구별한다. 항목이 버킷에 하나뿐이면 빠르지만 모두 한곳에 몰리면 전체를 살피게 된다. 키 문자열을 해시하거나 비교하는 자체 비용도 길이에 따라 달라진다.
적재율 α=n/m은 버킷 수 대비 저장 항목 수다. 균등하게 퍼진다는 가정과 적절한 적재율에서 조회·추가·삭제는 기대 O(1)로 설명할 수 있다. 최악에는 O(n)이 가능하다. 보통 적재율이 커지면 버킷 수를 늘리고 모든 항목의 위치를 다시 계산하는 리해시를 한다.
확장에는 O(n) 비용이 들 수 있으나 비율 기반 확장으로 연속 삽입의 분할 상환 비용을 관리한다. 반면 해시가 입력 공격에 취약하면 평균적인 분포 가정이 무너질 수 있다. 언어 구현의 난수화나 충돌 대응은 실제 보안과 성능에 영향을 준다.
키를 저장한 뒤 해시나 동등성에 영향을 주는 내용을 바꾸면 검색이 원래 위치를 찾지 못할 수 있다. 또한 기본 해시 테이블은 정렬 순서를 보장하지 않는다. 빠른 키 검색이 목적이라는 계약과 순서·범위 검색의 요구를 분리해서 선택해야 한다.
버킷 수를 바꾸면 단순히 기존 배열 뒤에 빈칸을 붙이는 것으로 충분하지 않다. h(key) mod m에서 m이 달라지므로 예전 항목의 목적지도 달라진다. 모든 항목을 새 규칙으로 옮기지 않으면 조회가 새 버킷을 찾아가도 기존 값은 다른 위치에 남는다.