힙 정렬: 최댓값을 뒤로 보내며 정렬 구간을 넓히기
힙 정렬은 배열을 최대 힙으로 만든 뒤 현재 최댓값을 배열 끝에 차례로 확정한다. 최대 힙은 부모가 자식보다 크거나 같으므로 루트가 가장 크다. 루트와 마지막 활성 원소를 바꾸고 힙 범위를 하나 줄이면 정렬된 뒤쪽이 넓어진다.
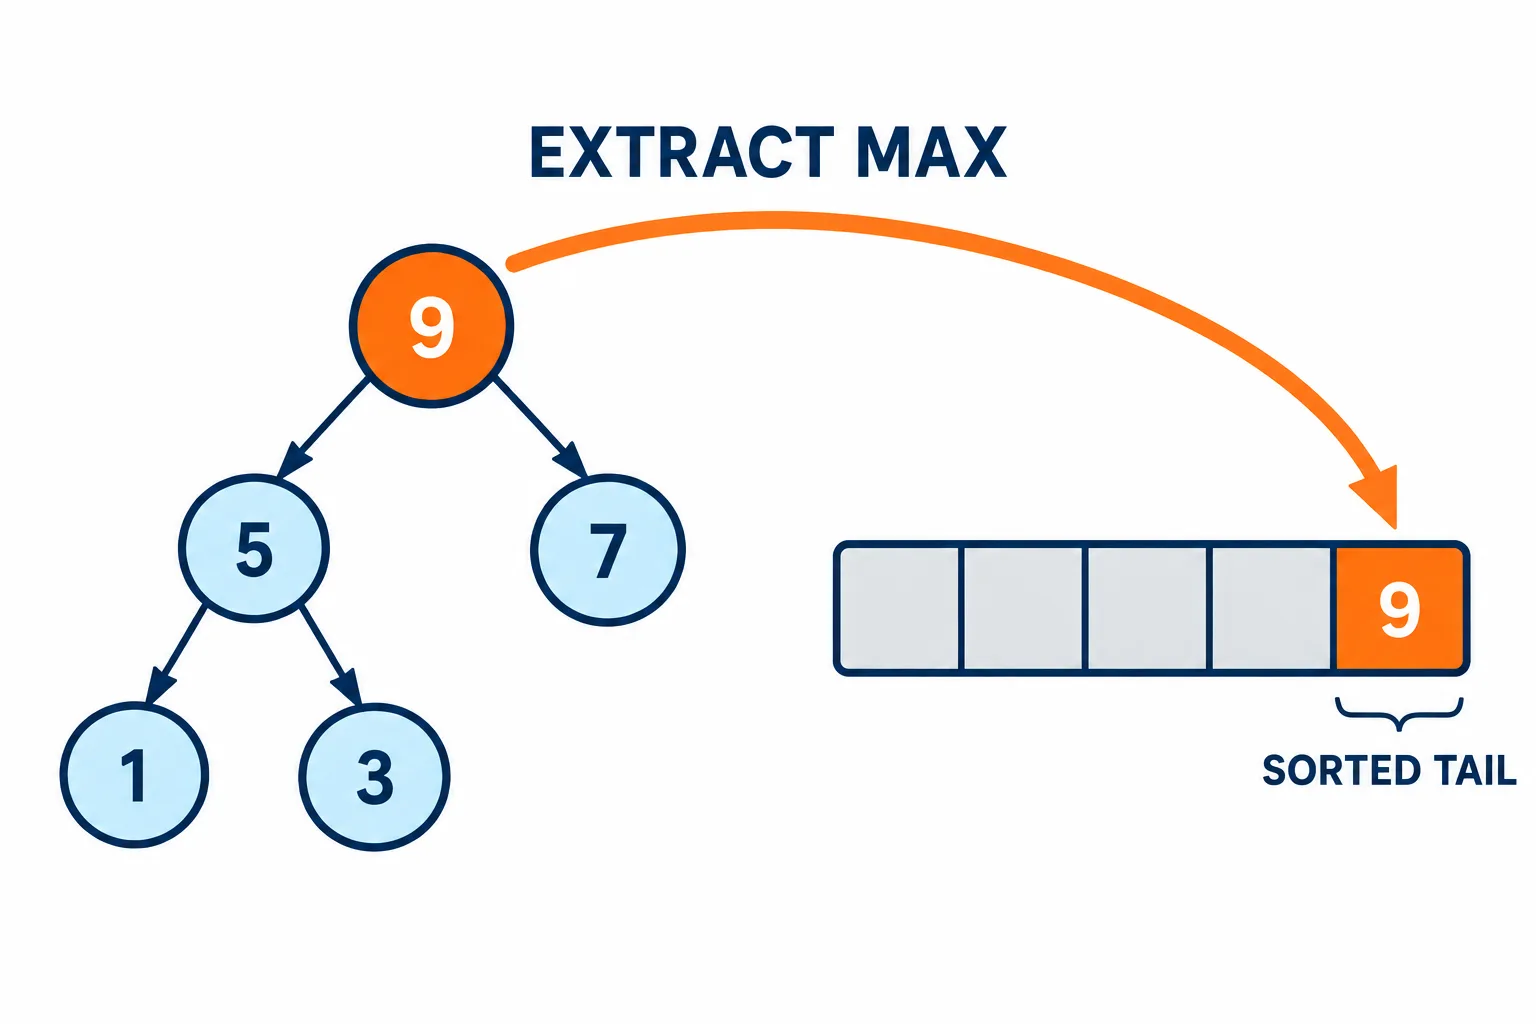
최댓값을 하나씩 꺼내며 정렬된 끝부분을 늘린다.
정렬된 구간과 힙 구간을 분리한다
[3,1,4,2]를 최대 힙으로 만들면 예를 들어 [4,2,3,1]이 된다. 루트 4를 끝의 1과 바꾼 뒤 마지막 칸을 제외하면 [1,2,3 | 4]다. 앞쪽을 다시 힙으로 만들면 3이 루트가 되고 다음 단계에 뒤에서 두 번째 위치로 보낸다.
여기서 경계 뒤의 원소는 이미 정렬되었으므로 sift-down이 그 구간을 건드려서는 안 된다. 전체 배열 길이와 현재 힙 길이를 따로 전달하는 이유다.
def sift_down(values, root, heap_size):
    while 2 * root + 1 < heap_size:
        child = 2 * root + 1
        if child + 1 < heap_size and values[child + 1] > values[child]:
            child += 1
        if values[root] >= values[child]:
            return
        values[root], values[child] = values[child], values[root]
        root = child

def heapsort(values):
    for root in range(len(values) // 2 - 1, -1, -1):
        sift_down(values, root, len(values))
    for end in range(len(values) - 1, 0, -1):
        values[0], values[end] = values[end], values[0]
        sift_down(values, 0, end)
위 구현은 오름차순 정렬을 위해 최대 힙을 쓴다. 최소 힙을 같은 방식으로 쓰면 큰 방향의 정렬 결과가 달라진다. 어떤 값을 먼저 확정할지와 결과 방향을 함께 생각해야 한다.
처음 힙 구성은 O(n)이다
아래쪽 내부 노드부터 복구하면 대부분 노드는 내려갈 수 있는 높이가 작다. 높이 h인 노드 수가 빠르게 줄어 전체 복구 비용은 O(n)이다. 이후 n개 가까운 추출 단계는 각 O(log n)이므로 총 최악 시간은 O(n log n)이다.
반복형 sift-down을 쓰는 위 코드는 추가 저장 변수가 일정 개수라 O(1) 보조 공간이다. 재귀 버전이라면 스택 공간을 따로 세어야 한다. 입력 순서가 정렬되어 있든 역순이든 최악 보장이 유지되는 장점이 있다.
멀리 떨어진 원소를 교환하므로 같은 키의 원래 순서가 바뀔 수 있어 보통 안정 정렬이 아니다. 또한 배열 내부 접근 패턴과 비교 횟수 때문에 실제 속도가 다른 O(n log n) 정렬보다 느릴 수 있다.
메모리를 적게 쓰면서 예측 가능한 최악 시간을 원하는 경우 유용하다. 이미 힙 자료구조를 알고 있어도 “끝으로 보낸 원소는 더 이상 힙에 포함하지 않는다”는 경계를 정확히 이해해야 완전한 정렬 알고리즘이 된다.