CPU 스케줄링: 누구를 먼저 실행해야 공정하고 빠를까
실행할 수 있는 프로그램이 CPU보다 많을 때 운영체제는 순서를 정해야 한다. CPU 스케줄링은 준비된 작업 가운데 무엇을 언제, 얼마나 실행할지 선택하는 정책이다. 선택을 실제로 수행하는 문맥 교환과는 역할이 다르다. 같은 전환 장치를 사용해도 어떤 정책을 적용하느냐에 따라 사용자가 느끼는 반응과 작업 완료 시간이 달라진다.
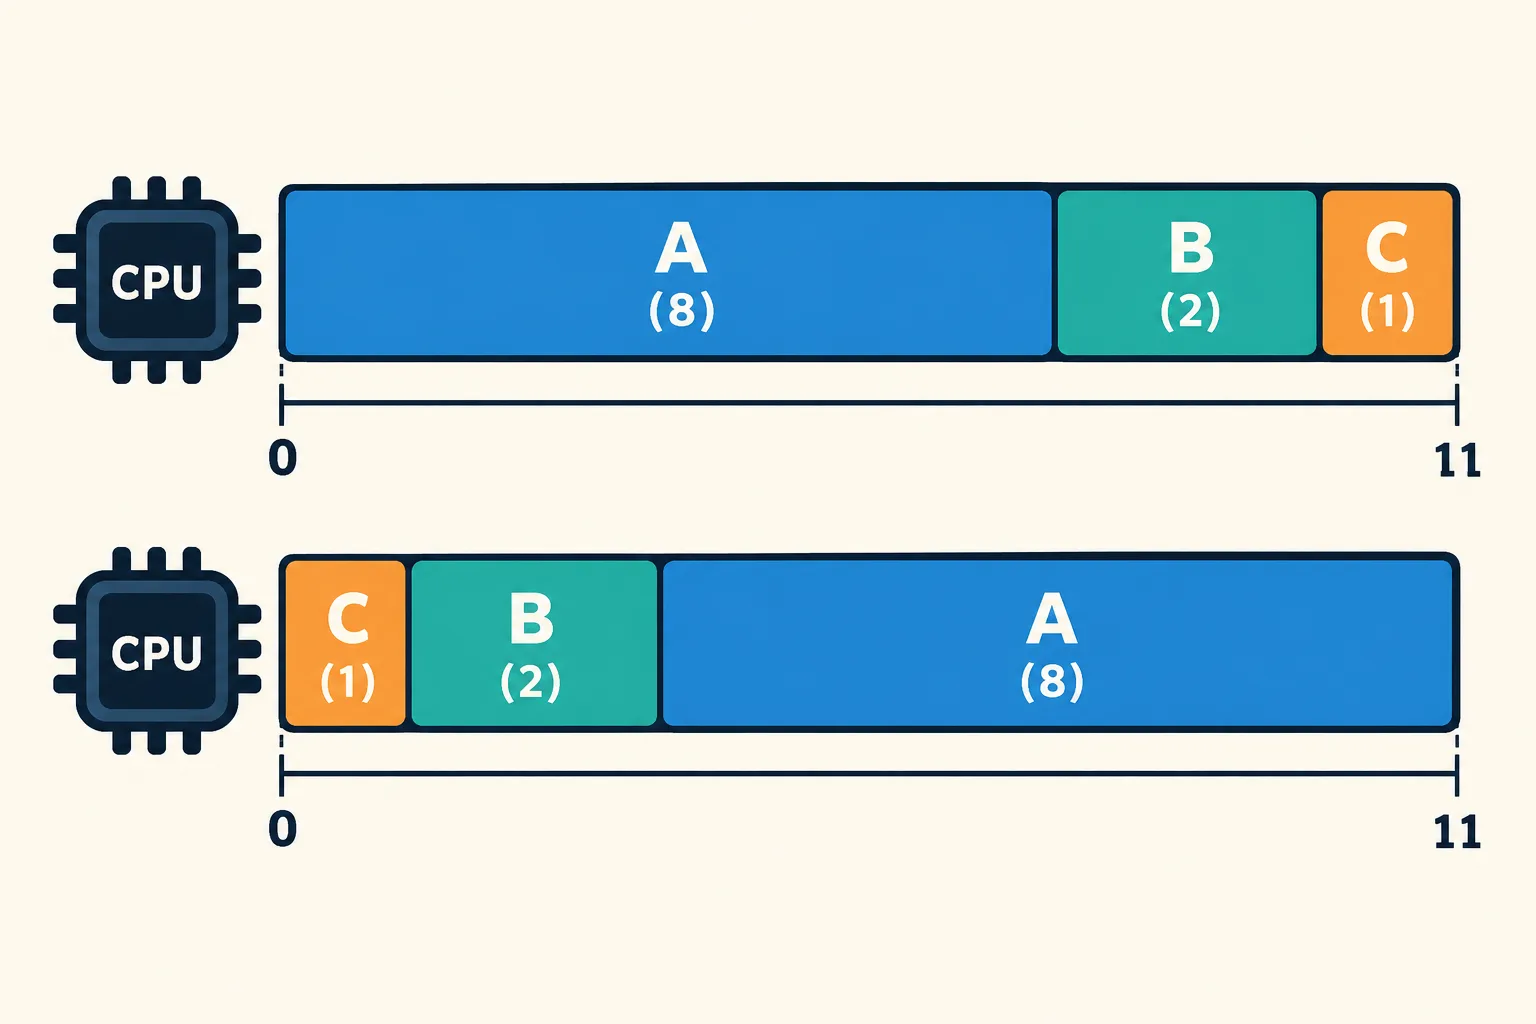
같은 작업도 실행 순서에 따라 평균 완료 시간이 달라진다.
먼저 목표를 정해야 한다
처리량은 일정 시간 동안 끝낸 작업의 수이고, 반환 시간은 작업 도착부터 완료까지의 시간이다. 응답 시간은 요청 뒤 첫 반응까지의 시간으로 볼 수 있다. 공정성은 작업 간 자원 배분을 얼마나 균형 있게 하는지에 관한 기준이다. 한 기준에서 유리한 정책이 모든 기준에서 유리하지는 않다. OSTEP의 스케줄링 장은 이 차이를 계산 예제로 설명한다.
먼저 도착한 작업을 먼저 끝내는 FCFS는 이해하기 쉽다. 그러나 긴 계산 작업 뒤에 짧은 작업이 줄지어 기다리면 응답이 나빠질 수 있다. 다음 CPU 실행 구간이 짧은 작업을 먼저 고르는 SJF는 특정 가정 아래 평균 반환 시간을 줄인다. 문제는 운영체제가 미래 실행 길이를 정확히 알기 어렵고 긴 작업을 계속 뒤로 미루면 기아가 생길 수 있다는 점이다.
같은 세 작업, 다른 체감
시각 0에 계산량이 각각 8, 2, 1인 A·B·C가 도착했다고 하자. 전환 비용을 무시하고 A부터 실행하면 완료 시각은 8, 10, 11이며 평균은 약 9.67이다. 짧은 C, B, A 순서로 실행하면 1, 3, 11이어서 평균은 5다. 이 예제는 모두 같은 시각에 도착하고 길이를 알고 있다는 가정 아래의 결과다.
라운드 로빈은 각 작업에 일정한 시간 할당량을 주고 차례를 돌린다. 긴 작업이 CPU를 독점하는 시간을 제한하므로 대화형 작업에 유리할 수 있다. 할당량이 아주 길면 FCFS에 가까워지고, 아주 짧으면 문맥 교환 비용이 커진다. 대기 중인 작업 수가 많으면 각자의 다음 차례까지 걸리는 시간도 늘어난다.
실제 작업의 성격은 변한다
프로그램은 계산만 하는 작업과 입출력만 기다리는 작업으로 완벽히 나뉘지 않는다. 같은 프로그램도 입력을 기다리다가 짧게 계산하고 다시 기다릴 수 있다. 다단계 피드백 큐 같은 정책은 과거 행동을 이용해 우선순위를 조정한다. 자주 CPU를 오래 쓰는 작업과 짧게 쓰고 대기하는 작업을 구분하려 하지만, 정책을 악용하거나 오래 기다린 작업을 굶기는 문제를 막는 보완이 필요하다.
여러 코어에서는 작업을 균등하게 나누는 부하 분산과, 같은 코어의 캐시를 다시 쓰게 하는 친화성이 충돌할 수 있다. 실시간 작업이라면 평균보다 마감 시각을 지키는 성질이 중요해진다. 우선순위가 높은 작업도 낮은 작업이 가진 잠금을 기다릴 수 있어, 스케줄러만으로 모든 지연을 해결하지는 못한다.
스케줄링을 공부할 때는 알고리즘 이름보다 가정을 먼저 적어 보면 좋다. 작업 도착 시각, 실행 길이의 알려짐 여부, 선점 가능성, 전환 비용, 목표 지표를 명시하면 계산 결과를 현실에 적용할 범위가 보인다. 빠르다는 표현을 응답성이 좋은지, 전체 완료가 빠른지로 나눠 보는 것만으로도 정책 선택이 훨씬 명확해진다.