DMA: CPU가 바이트마다 복사하지 않아도 데이터가 이동하는 법
장치에서 큰 데이터를 가져올 때 CPU가 모든 바이트를 직접 읽고 RAM에 쓰면 계산 시간을 많이 쓴다. DMA, Direct Memory Access는 장치나 전송 엔진이 메모리와 데이터를 주고받도록 하는 방식이다. CPU는 버퍼와 전송 조건을 준비하고 시작을 요청하며, 전송 중에는 다른 일을 할 수 있다. 완료 확인과 결과 사용에는 여전히 소프트웨어의 협력이 필요하다.
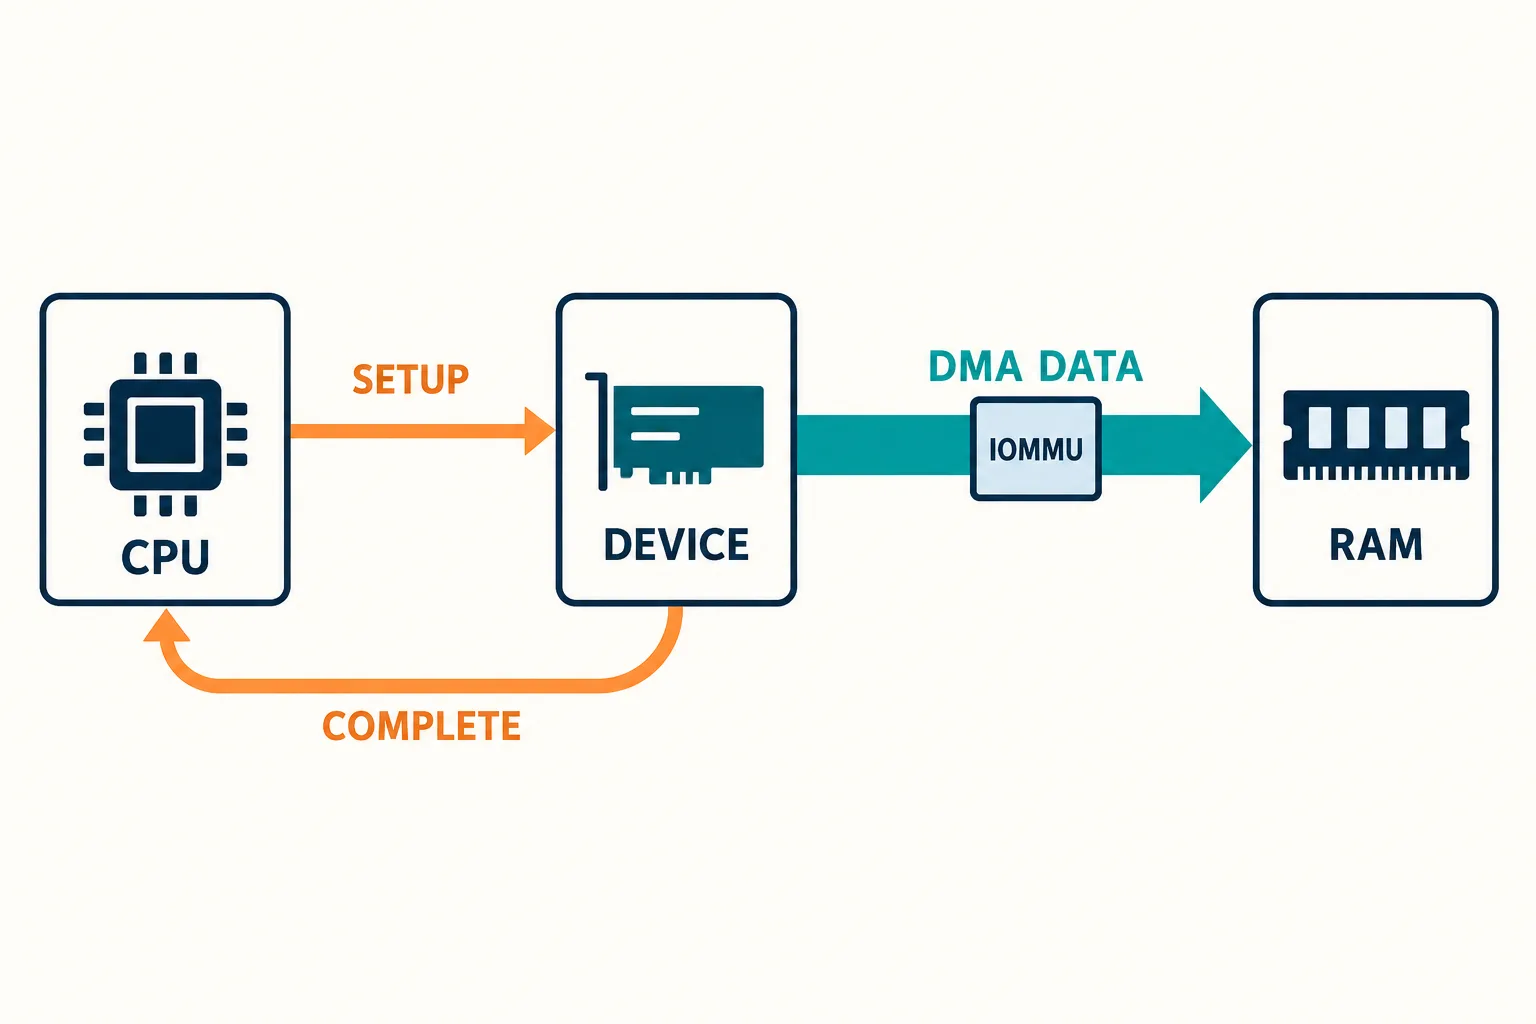
DMA는 데이터 이동을 장치에 맡기지만 주소 매핑과 버퍼 수명은 소프트웨어가 관리한다.
준비·전송·완료를 나눠 본다
네트워크 수신을 단순화해 보자. 드라이버는 받을 버퍼를 마련하고 장치가 사용할 주소와 길이를 전달한다. 장치는 도착한 데이터를 그 버퍼로 이동시키고 완료 상태를 기록하거나 인터럽트로 알린다. CPU는 완료된 버퍼를 확인해 상위 소프트웨어에 전달한다. CPU가 사라지는 것이 아니라 바이트별 이동과 전송 관리의 역할이 분리되는 것이다.
DMA에 쓰는 주소가 프로그램의 일반적인 가상 주소와 같다고 가정하면 안 된다. CPU의 주소 변환과 장치가 사용하는 접근 경로는 다를 수 있다. Linux의 DMA 매핑 가이드는 가상 주소, 물리 주소, 장치가 쓰는 DMA 주소를 구분하고 필요한 IOMMU 매핑을 설명한다. 드라이버는 플랫폼이 제공하는 API로 장치에 맞는 주소를 얻어야 한다.
장치가 보는 범위를 설정한다
일부 시스템에서는 장치 주소가 직접 물리 메모리에 대응하고, 다른 시스템에서는 IOMMU가 장치 주소를 물리 위치로 변환한다. 장치가 표현할 수 있는 주소 폭에도 제한이 있을 수 있다. 큰 메모리가 있다고 모든 장치가 그 전체를 같은 방식으로 접근할 수 있는 것은 아니다. 매핑과 버퍼 배정의 규칙은 장치 능력과 플랫폼을 함께 반영한다.
물리적으로 떨어진 여러 버퍼를 목록으로 전달하는 scatter-gather 방식은 연속된 하나의 구간을 확보하는 부담을 줄일 수 있다. 하지만 목록 항목 수, 정렬, 크기 제한 등 장치 규칙이 있다. CPU에서 연속으로 보이는 가상 영역이 DMA에서도 하나의 연속 주소 구간이라고 단정하면 안 된다.
캐시와 소유권이 맞아야 한다
CPU가 캐시에 가진 데이터와 DMA 장치가 메모리에 쓰는 내용 사이의 일관성을 관리해야 한다. 하드웨어가 일관된 접근을 제공하는 시스템도 있고 API의 동기화가 필요한 시스템도 있다. 전송 방향과 버퍼 사용 시점에 맞춰 동기화해야 하며, 준비가 끝나기 전에 CPU가 읽거나 장치가 아직 사용하는 버퍼를 재활용하면 문제가 생긴다.
매핑을 해제하거나 버퍼를 반환하는 시점 역시 전송 완료와 연결된다. 완료를 알리는 상태가 기록된 순서와 실제 데이터의 관찰 가능성도 해당 API 규칙을 따라야 한다. 단순히 인터럽트를 받았으니 모든 메모리에 임의로 접근해도 된다고 생각하면 안 된다. 버퍼는 CPU와 장치 중 누가 사용하는지 명확한 수명과 전환 규칙을 가져야 한다.
DMA에는 준비와 매핑 비용이 있어 아주 작은 전송에서는 다른 접근보다 이점이 적을 수 있다. 큰 전송에서도 메모리 대역폭과 연결망을 공유하므로 CPU의 다른 작업을 늦출 수 있다. zero-copy와도 같은 뜻은 아니다. DMA로 장치와 RAM 사이를 옮긴 뒤 응용 버퍼로 추가 복사가 일어날 수 있다.
DMA는 디스크, 네트워크, 오디오 등에서 CPU의 직접 이동 부담을 줄이는 핵심 기법이다. 성능을 평가하려면 전송량과 CPU 사용률뿐 아니라 준비·완료 지연, 메모리 복사 횟수, 버퍼 재사용을 살펴야 한다. 데이터 이동의 주체를 바꾸는 만큼 주소 해석과 캐시, 수명에 대한 계약도 함께 지켜야 한다.