KMP 문자열 검색: 실패한 비교에서도 정보를 남기는 방법
KMP는 텍스트 안에서 패턴을 찾을 때 이미 일치한 문자들의 정보를 이용하는 알고리즘이다. 불일치가 발생했다고 텍스트 위치를 처음부터 되돌리지 않는다. 패턴의 접두사와 접미사 관계를 미리 계산해 다음 비교 위치를 정한다.
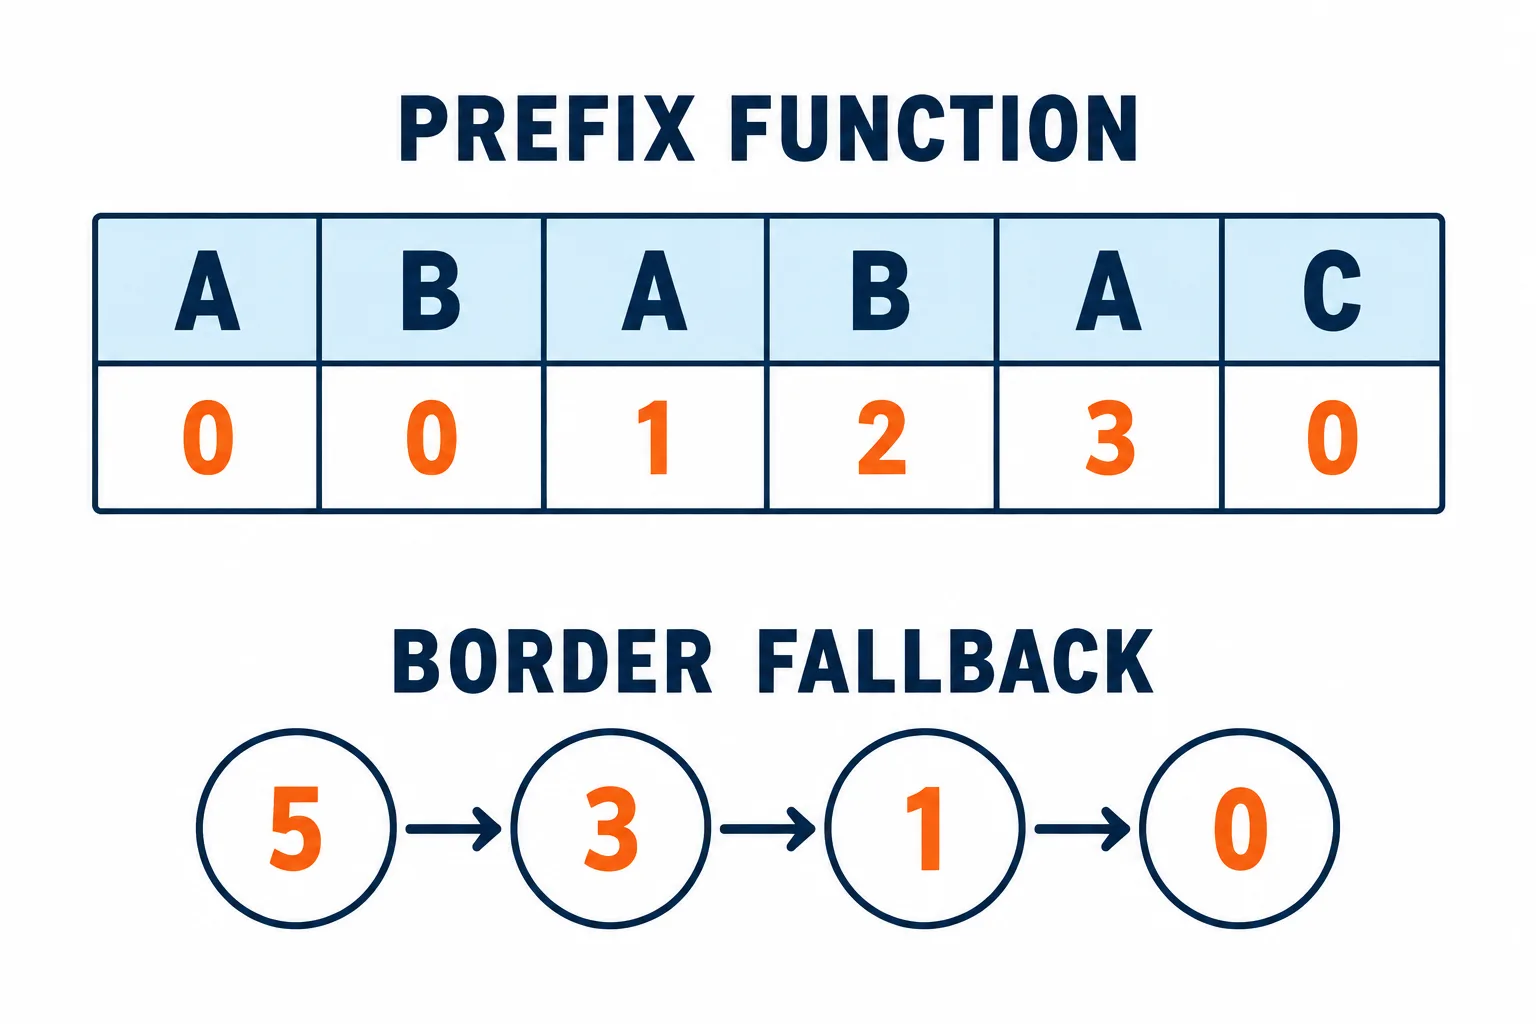
불일치가 발생해도 이미 확인한 접두사와 접미사 관계를 이용해 비교를 이어간다.
접두 함수의 의미
pi[i]는 패턴의 0부터 i까지 구간에서 자기 전체를 제외한 가장 긴 접두사이면서 접미사인 문자열 길이다. 패턴 abab의 pi는 [0,0,1,2]다. 마지막까지 본 구간에서 ab가 양끝에 나타나기 때문이다.
def prefix_function(pattern):
    prefix = [0] * len(pattern)
    for index in range(1, len(pattern)):
        matched = prefix[index - 1]
        while matched > 0 and pattern[index] != pattern[matched]:
            matched = prefix[matched - 1]
        if pattern[index] == pattern[matched]:
            matched += 1
        prefix[index] = matched
    return prefix

def find_all(text, pattern):
    if not pattern:
        return list(range(len(text) + 1))
    prefix = prefix_function(pattern)
    matched = 0
    positions = []
    for index, character in enumerate(text):
        while matched > 0 and character != pattern[matched]:
            matched = prefix[matched - 1]
        if character == pattern[matched]:
            matched += 1
        if matched == len(pattern):
            positions.append(index - len(pattern) + 1)
            matched = prefix[matched - 1]
    return positions
코드는 빈 패턴을 모든 경계 위치에서 일치한다고 정의한다. 이 계약은 구현마다 달라질 수 있다. 일치 후 matched를 0이 아닌 접두 길이로 바꾸므로 겹치는 일치도 발견한다. ababa에서 aba는 위치 0과 2에 있다.
어디까지 되돌아가도 안전한가
텍스트 끝부분이 패턴 접두사 j개와 일치했다면 불일치 이후에도 그 끝의 접미사 일부가 패턴의 접두사일 수 있다. 가장 긴 후보는 pi[j-1]이다. 그 후보도 맞지 않으면 더 짧은 접두 후보를 따른다. 아무 위치로 점프하는 것이 아니라 가능한 재사용 길이를 선택한다.
텍스트 포인터는 오른쪽으로만 이동한다. matched가 늘어난 횟수와 줄어든 횟수를 전체로 합산하면 전처리 O(m), 검색 O(n+m)을 얻는다. while이 for 안에 있다고 O(nm)으로 판단하면 전체 이동 횟수를 놓친다.
접두 배열은 O(m) 공간이고, 모든 일치 위치를 저장하면 결과 수만큼 추가 공간이 든다. 입력의 문자 단위도 중요하다. 유니코드 정규화, 대소문자 무시 같은 조건은 문자 비교 이전에 별도 정의해야 한다.
KMP는 최악 선형 시간의 정확한 매칭을 제공한다. 해시 충돌 가정이 필요 없지만 편집 거리나 와일드카드 검색을 그대로 해결하지는 않는다. 접두 함수의 의미와 불일치 시 현재 일치 길이가 무엇을 보존하는지 이해하면 복잡해 보이는 점프가 규칙적으로 읽힌다.